Pages

▼

Thursday, March 24, 2016

딥러닝을 이용한 추천엔진 (넷플릭스 컨테스트) 코드 설명

재미있는 글이 올라왔습니다.
https://karthkk.wordpress.com/2016/03/22/deep-learning-solution-for-netflix-prize/
딥러닝으로 협업 필터링(collaborative filtering) 문제를 푸는 코드입니다.

넷플릭스

는 우리가 다 아는 그 넷플릭스입니다.

컨테스트

각 사용자가 영화에 매긴 평점을 학습 데이터로 줍니다. 그리고 사용자가 다른 영화엔 어떤 평점을 줄지를 예측하는 문제입니다. 이걸 이용해서 사용자가 좋아할법한 영화를 추천할 수 있겠죠. 
해당 컨테스트는 100만달러의 상금이 걸려있었고 몇차례 잘 진행되었으나 개인정보관련 문제로 소송이 들어와서 중단되었습니다. 이후에도 데이터를 이용해 논문을 쓰는건 막을수가 없어서 사람들이 계속 활용하고 있습니다.
아마 컨텐츠 추천으로는 제일 널리 쓰이는 데이터셋일겁니다.

요번에 나온 코드

는 아래와 같습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
movie_count = 17771
user_count = 2649430
model_left = Sequential()
model_left.add(Embedding(movie_count, 60, input_length=1))
model_right = Sequential()
model_right.add(Embedding(user_count, 20, input_length=1))
model = Sequential()
model.add(Merge([model_left, model_right], mode='concat'))
model.add(Flatten())
model.add(Dense(64))
model.add(Activation('sigmoid'))
model.add(Dense(64))
model.add(Activation('sigmoid'))
model.add(Dense(64))
model.add(Activation('sigmoid'))
model.add(Dense(1))
model.compile(loss='mean_squared_error', optimizer='adadelta')

별로 아름답게 코드가 안뜨지만 양해 바랍니다.

설명

  • [1] 데이터에 있는 전체 영화의 수입니다.
  • [2] 데이터에 있는 전체 사용자의 수 입니다.
  • [3-6] 영화의 인덱스를 60차원 벡터로, 사용자 인덱스를 20차원 벡터로 바꿔주는 embedding층을 추가합니다. keras문법을 참고하면, 입력은 [[1],[3],[9],[232423],[534]...], 즉 영화의 인덱스를 받고 그 인덱스 하나하나를 60차원의 벡터로 변환해줍니다. 사용자도 마찬가지구요. 
  • [7-8] 여기에서는 위에서 embedding층의 결과를 다시 입력으로 받습니다. 두 개의 embedding벡터를 이어줍니다.
  • [9-16] 그리고 3개의 dense layer, 혹은 fully connected layer, 혹은 일반적인 인공신경망의 층을, 혹은 3개의 MLP를..아무튼 뉴럴넷을 이어줍니다. 최종 출력은 노드가 1개인 스칼라 값이네요. 넷플릭스는 총 5단계 (1,2,3,4,5)로 평가합니다. 따라서 값의 범위가 1-5인데, 이걸 그대로 사용했군요. 
  • [17] MSE로 loss function을 정해주고 adadelta로 최적화합니다.
여기에서 일어나는 학습을 세 가지로 나눠볼 수 있겠네요.
  1. 영화 인덱스 → 60차원 벡터
  2. 사용자 인덱스 → 20차원 벡터
  3. 80차원의 벡터 [60차원 영화 임베딩 + 20차원 사용자 임베딩] → 스칼라 값 (평점)
이 세 가지 학습의 목표는 평점을 정확히 예측하는 것 이구요.
보통 추천 시스템에서 사용하는 Matrix factorisation과 풀이 과정이 달라서 좀 이해가 안갔는데, 아예 다른 접근법이라고 보면 될 것 같습니다. 

생각할 거리

  • 출력층의 [1,2,3,4,5]값을 [0.2, 0.4, 0.6, 0.8, 1.0]으로 바꿔주고 (혹은 [0.1, 0.3, 0.5, 0.7, 0.9]가 더 괜찮을지도..) 출력층에도 sigmoid를 적용한 뒤 crossentropy를 쓰거나,
  • [1,2,3,4,5]의 범주로 분류하는 분류 문제(classification problem)으로 설정하고 softmax를 쓰면 어떻게 될지 궁금하네요.
  • 그 외에 다양한 머신러닝 학습 기법이 어떻게 적용될 수 있을런지도 마찬가지로..
  • 이 방법이 정말 테스트셋에서도 잘 된다면 굉장한겁니다. 엔지니어링쪽은 잘 모르지만 일단 새 아이템 엔트리를 추가하기도 아주 간단하고 (학습데이터에 그냥 넣어서 계속 돌리면 되죠) 메모리도 많이 차지할 것 같지 않은데요? 저정도 크기의 파라미터는 GPU메모리에 충분히 들어갈테니...
  • 업데이트된 글에 의하면 실제 컨테스트에서 썼던 test set과, 글에 나온것처럼 트레이닝셋을 나눠서 하는것과는 성능 차이가 좀 난다고 하네요. test set의 경우엔 아예 평점을 매긴 날짜 자체가 다르고 등등, 난이도 차이가 있다고 합니다. 

Friday, March 11, 2016

음성/음악신호+머신러닝 초심자를 위한 가이드 [2편]

음성/음악신호+머신러닝 초심자를 위한 가이드 전체 게시물은 여기를 클릭하세요.

개요

지난번 포스팅 (음성/음악신호+머신러닝 초심자를 위한 가이드 [1편])에서는 아주 간단한 MFCC 추출 - 로지스틱 회귀 분류기를 사용한 예제를 설명드렸습니다. 놀랍게도 제가 2편을 쓰는군요. [1편]은 잘 이해하셨나요? 디지털 신호와 공학 수학에 대한 간단한 배경 지식이 있었다면 잘 이해하셨을겁니다. 이번 [2편]은 [1편]의 확장판입니다.

1편의 구조를 간략히 정리하면 아래와 같습니다.

<구조>
음악,음성신호 입력 --> [전처리] --> [특징값 추출] --> [분류기] --> 결과

<예>
애기가 우는 소리 녹음파일 -->[전처리:애기가 응애응애 하는 구간만 잘라냄] --> [특징값: MFCC] --> [분류기:로지스틱 분류기] --> 배고프다 vs 졸리다 판별

이번엔 각 단계를 좀 더 고도화 할 수 있는지 알아보겠습니다.

전처리

전처리란 말 그대로 데이터를 머신러닝 알고리즘에 넣기 전에 사용에 용이하도록 처리를 해주는 것 입니다. 자동으로 전처리를 해줄 수도 있고, 수동으로 하는 방법도 있겠죠. 전처리는 굉장히 중요합니다. 입력 데이터가 엉망이면 아무리 훌륭한 알고리즘을 짜도 좋은 성능을 장담하지 못합니다. 아니 나쁜 성능을 장담합니다; 오디오 신호의 경우에 전처리 방법은...애기가 응애응애 하는 구간만 쏙 잘라준다.
    • VAD (voice activity detection:음성 탐지)를 쓴다든지, 신호의 크기가 다들 비슷비슷하다면 단순히 프레임의 평균/최대 진폭을 비교한다. 후자의 경우 오디오 편집 툴에서 [노이즈 게이트]를 활용하면 된다.
  • SNR확보: 신호의 잡음을 줄여준다.
    • EQ, 필터: 신호가 존재할 수 있는 주파수 대역을 증폭시키거나 반대로 없는 부분을 자름.
  • 볼륨 정규화: 오디오 신호의 진폭(amplitude)를 최대값 ([-1, 1])로 키워줘서 디지털 신호에 할당된 비트수를 최대한 활용하도록 한다.
등이 있습니다. 그리고 오디오랑 관계 없이 일반적으로 활용되는 전처리 방법은
  • Normalization
  • Whitening (데이터의 분포를 평균을 0, 표준편차를 1로 맞춰준다)
  • PCA - Principle Component Analysis (자세한 설명은 여기!) 를 써서 고차원 데이터를 압축한다
등이 있습니다.
다시 한 번 말씀드리면, 전처리는 정말 중요합니다. 신호가 가지고 있는 정보를 최대한 보존하면서 전체 데이터의 크기를 최소화 해야 효율적으로 연산을 할 수 있습니다. 그리고 정규화 등 데이터의 분포가 일정하지 않으면 성능에 영향을 줄 수 있습니다. 물론 좋지 않은 영향입니다. 만일 전처리 단계에서 처리가 안된다면 특징값 추출을 더욱 훌륭하게 짜야하겠죠.

특징값 추출 (feature extraction)

무지, 무지, 무지 중요합니다. 딥러닝이 대세가 되기 이전의 오디오+머신러닝 연구는 어떻게 하면 특징값 추출하는 방법을 잘 고안해내서 원하는 작업을 할 수 있을까 였습니다.
가이드 1편에서는 고민없이 MFCC를 사용했었죠? MFCC는 활용 범위가 아주 넓습니다. 그러나 언제 써먹을 수 있는지를 구체적으로 알아둬야 하겠죠. 아래 설명드리겠습니다.

  • MFCC
수식은 여기저기 다 나옵니다. 저는 핵심적인 개념과 의미만 설명하겠습니다.
    • 음색(timbre)은 악기 소리나 사람 목소리를 구별할 수 있게 해주는 그야말로 음색의 차이입니다. 흔히 '톤'이라고 표현하기도 하죠.
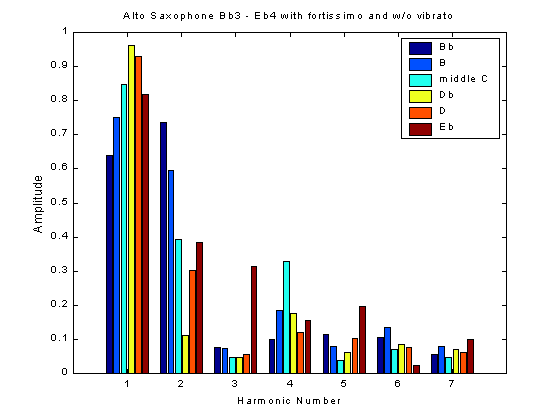
    • 공학적으로 보면 음색을 좌우하는 하는 아주 중요한 요소는 바로 악기 혹은 목소리의 배음 구조입니다. 같은 '라 - 440Hz'를 쳐도 피아노와 기타의 음색이 다른건 '라' 음은 440Hz뿐만 아니라 880Hz, 1,320Hz, 1,760Hz..등 440*[1,2,3,4,5,6..] Hz 의 주파수로 이루어져있고, 이 주파수의 에너지 비율이 다르기 때문입니다. 이걸 한마디로배음 구조가 다르다고 표현합니다.
    • 얼만큼 다르냐면요, 같은 관악기에서도 이만큼 다릅니다. 
    • 그리고 이 배음구조의 차이는 악기의 구조에 따라 좌우되며,
    • MFCC는 이 배음 구조의 차이를 표현하는 숫자입니다.
MFCC의 특징은,
    • 음정 (음고, pitch)이 변해도 MFCC가 (나름대로) 일정하게 유지된다는 점 입니다. 따라서,
음성 인식, 음악의 장르 분석, 감정 인식 등 다양한 분야에서 MFCC를 활용합니다. 예를 들어 음성을 인식해야 하는데 목소리가 높은 사람이 높은 음으로 '가나다라~' 하는거랑 낮은 목소리로 '가나다라~' 하는거랑 같게 인식이 되어야 하겠죠? 그러니 MFCC는 적합한 특징값이죠.
반대로 음악에서 악기를 연주하면 그 악기의 음표를 그려주는 목적이라고 하면 MFCC는 절대 사용해선 안되겠죠. 음정의 차이를 무시하도록 디자인되었으니까요.

  • 그 외에
    • spectral centroid
    • spectral rolloff
    • zero-crossing
    • spectral flux
    • energy
여기에서 다 열거하기 어려울 만큼 많은 특징값이 있습니다. 우선 각자가 어떤 특징값을 갖는지 잘 알아보시고, 필요하면 구현해서 쓰시기 바랍니다. 그리고 구현이 귀찮은 분들 (==바로 당신..)을 위해 YAAFE, Sonic Annotator 등 좋은 툴이 많이 있습니다.

Bag of Feature: 특징값 가방;모음;덩어리;..

문제가 있습니다. 특징값의 종류가 너무 많아요. 어떤걸 써야 할지, 어떤 것이 효과적인지, 상대적으로 뭐가 더 중요한지 일일이 고민하기가 까다롭습니다. 특징값 추출을 고안한 사람이 주장하는 효과가 실제로 나온다는 보장도 없구요. 으! 열받는다! 그래서... 그래서 좋은 방법이 있습니다.

다 갖다 써!

시간이 지날수록 컴퓨터의 연산량과 메모리는 늘어납니다. 그러니, 그냥, 수많은 특징값을 다 추출해서 전부 때려넣고 알아서 자동으로 중요한 걸 골라서 쓰게 한다면 참 좋겠죠? 아래처럼요.

<새로운 구조>
음악,음성신호 입력 --> [전처리] --> [특징값 왕창 추출] -->[중요한거 골라주셈] --> [분류기] --> 결과

그래서 어느 순간부터 사람들은 이렇게 하기 시작했습니다. 막, 오디오 프레임 하나에 특징값을 수십, 수백개 쓰는거죠. 전 대충 1x1000 벡터로 (즉 프레임당 특징값이 1000개) 쓰는 것 까지 봤습니다. 그러니까, MFCC 20개, dMFCC 20개, ddMFCC 20개, spectral centroid 1개, zero-crossing 1개, ... 이렇게 잔뜩 구해서 얘네들을 쭉- 붙여서 하나의 벡터로 만들어주는 거죠. 이렇게 해서 프레임마다 1x200짜리 벡터가 나왔다고 치죠. 그런데 문제는 우리는 프레임 마다 특징값을 뽑는 것이 아니라 오디오 신호 전체를 표현할 특징값이 필요하거든요. 이것도 방법이 많지만 제일 간단한 방법은 그냥 각자 평균과 분산을 구해주는 겁니다. 그러면 최종적으로는 1x200 평균과 1x200 분산 --> 1x400 벡터가 되겠죠. 그래도 연산량이 남으면 max()를 추가하면 또 200차원 추가요~ (사실 더 좋은 방법이 있습니다만 여기선 생략합니다. 이 논문에서 어떻게 했나 참고하세요.)

그럼 어떻게 중요한걸 골라주냐면, 전처리 섹션에서 언급한
을 쓰는 겁니다! 자세한 설명은 자세한 설명은 여기!를 참고해주세요.

분류기

분류기는 자세히 다루지 않겠습니다. 그러나 분류기를 고르는 법을 알려드릴게요.

"제일 간단한것부터 해보고 성능이 맘에 안들면 더 복잡한 분류기를 써봐라. 그러나 성능이 비슷하다면 반드시 제일 간단한 것을 사용해라. "
네, 오컴의 면도날이죠. 

절대 쓰다가 귀찮아져서가 아닙니다. 

용어


  • 특징값 == feature
  • 분류기 == classifier
  • 추출 == extraction
  • 전처리 == preprocessing