- 자기 소개서
- Q. 자기 소개서에 쓸 내용이 너무 없어요.
- A. 자기 소개서에 쓸 내용을 만들었어야합니다. 공부를 했다면 그 내용을 정리해서 인터넷에 올리세요. 연구를 도운게 있다면 공저자로 이름이 들어있겠죠? 그걸 사용하세요. 뽑는사람 입장에서는 이 사람을 뽑았을 때 혹시나 깽판치거나 완전 말아먹을수도 있다는 걱정을 항상 하게됩니다. 따라서 그런 불안감을 줄여주려면 근거 없는 경험을 나열하는게 아니라 신뢰할 수 있는, 권위 있는 사람이나 소속이 연관된 뭐라도 하셔야합니다.
- 지금까지 한게 없으면 지금부터라도 하세요. 1달이라도 의미있는걸, 그리고 문서화할 수 있고 설명이 가능한걸 뭐라도 하고 그걸 적으세요. 만일 수 개월의 시간이 있다면 분명 의미있는 활동을 할 수 있습니다.
- Q. 자기 소개서를 교수가 읽나요?
- A. 읽는다고 가정하고 쓰세요.
- Q. 주의사항
- A. 본인이 참여한 프로젝트나 기관을 너무 열심히 설명하지 마시고 본인이 참여한 이유, 맡은 역할, 배운 내용을 쓰세요. 즉 본인이 뭘 하셨는지를 적으셔야합니다. 자기소개서는 내 예전 직장 소개서가 아닙니다.
- 연구계획서
- Q. 전 아는게 없는데 연구계획서를 어떻게 쓰죠?
- A. 연구계획서를 쓸 수 있도록 해당 분야의 논문, 서적, 발표자료 등을 면밀히 찾아보시길 바랍니다.
- Q. 대학원 다니는 동안 연구계획서대로 진짜 연구를 수행해야 하나요?
- A. 아뇨, 실제로 연구하는 내용은 엄청나게 바뀔겁니다. 그렇지만 현 시점에서 최대한 노력해서 쓰셔야합니다.
- Q. 연구계획서를 교수가 읽나요?
- A. 읽는다고 가정하고 쓰세요.
- 그 외
- 자기소개서에서는 본인의 과거를 소개합니다. 어지간하면 최근 몇 년만 적으세요.
- 연구계획서에는 본인이 미래에 - 향후 몇 년 간 - 뭘 할지 적습니다.
- 따라서 두 문서는 내용이 겹치거나 같은 말을 반복하지는 마세요. 그러나,
- 과거에 나는 이런이런걸 했고, 이건 나의 어떠한 면을 보여주며, 내 관심 분야를 이렇게 공부해왔고,
- 미래에도 이걸 계속하고 싶으며 이러이러하게 열심히 잘 할것이니 뽑아달라.
- 로 일맥상통해야 합니다.
- 연구계획서에 적힌 연구 내용은 당연히 지원하는 학교와 잘 맞아야합니다. 교수의 논문 목록을 찾아보시면 최근 관심분야가 나오겠죠.
- 자기소개서나 연구계획서가 당락을 가르는지 관심갖지 마세요. 그냥 열심히 준비하세요. 교수마다 다르고, 학교마다 다르고, 기분따라 다릅니다. 남들이 어떻게 하는지, 어떻게 했는지는 전혀 중요하지 않습니다.
Wednesday, July 5, 2017
유학 준비 - 자기소개서와 연구계획서 작성법
간결하게 쓰겠습니다.

Wednesday, June 14, 2017
음성/음악신호+머신러닝 초심자를 위한 가이드 [4편]
음성/음악신호+머신러닝 초심자를 위한 가이드 전체 게시물은 여기를 클릭하세요.
데이터 수집
이번엔 데이터 수집을 주제로 글을 쓰겠습니다.
기존 데이터셋 사용
음악 데이터 셋은 http://www.audiocontentanalysis.org/data-sets/ 여기에 잘 정리되어있습니다.
오디오 관련 데이터셋은 좀 더 중구난방인데,
- Urbansound8K by Justin Salamon
- DCASE audio detection by Queen Mary University of London
- Bird Audio Detection by Queen Mary University of London
이 정도가 생각나네요.
데이터 수집
살다보면 힘들고 험한 길을 가야할 때가 있죠.
freesound에서 직접 크롤링해서 뭔가 할 수 있지 않을까? 하는 희망을 한번쯤은 품어볼 필요가 있습니다.
아래 코드를 참고하세요. 주소는 여기
데이터 정리
데이터를 모으는게 다가 아니죠. 일단, 키워드로 검색을 했으니 특정 소리가 들어있는 음악 파일을 잔뜩 받았다고 해봅시다. 뭘 해야할까요?- Normalisation
import numpy as np
import librosa

x = librosa.core('event1.mp3', sr=None, mono=True)
x = x / np.max(np.abs(x))
- Trimming
앞뒤에 조용한 구간이 있다면 싹둑 잘라주는편이 좋겠죠. 이건 어느정도 대애충 감으로 하는게 편할것같네요. 저라면, hann window같은걸 씌우고, 각 윈도에서 평균 에너지를 구해서 (np.mean(np.abs(windowed_source_x) ** 2)), 그 윈도 별 평균 에너지를 기준으로,아무런 음향 이벤트가 안일어나는 첫 N개의 윈도와 마지막 M개의 윈도를 날리겠습니다.
- Augmentation
데이터가 부족하면 뻥튀기를 하고싶겠죠? 방법은 여러가지가 있습니다. 적당한 구간에서 pitch shift / time expanding을 하시면 무난할테고, 다른 잡음을 적당히 섞어주는것도 좋겠죠 (x = x + gain * noise). 이 정도만 해도 벌써 10배이상 데이터가 늘어날 것 같네요.
- 주의사항
음원이 매우 길다거나해서 여러 개의 학습 데이터 샘플로 쪼개서 쓰는 경우에, 같은 음원에서 나온 샘플 여러개가 training/validation/test 셋에서 섞이지 않도록 주의합시다.
이상입니다.
Friday, December 30, 2016
번역 - Generative Adversarial Network (GAN) 설명
오랜만에 설명 자료 하나 번역합니다. 주로 http://blog.aylien.com/introduction-generative-adversarial-networks-code-tensorflow/ 를 보고 번역합니다만 적당히 편집과 내용추가가 있어서 1:1 번역은 아닙니다.
GAN?
시선을 끌기위해 예제부터 뽑아오자. 아래 예제가 GAN으로 만든 - 요즘 신문기사처럼 표현하면 "인공지능이 그린" 그림이다.


서문
최근에 GAN: Generative Adversarial Network가 무지무지 인기를 끌고있다. GAN은 Ian Goodfellow가 https://arxiv.org/abs/1406.2661 등에서 제안한 것이다. 참고로 2014, 2015년에 Adversarial example 등 용어가 범람하면서 다소 개념이 애매한 부분이 있는데, 이는 Ian Goodfellow의 Quora답변을 참고하자. 아무튼 위대한 Yann LeCun이 꼽은 중요한 기술 1위 GAN이라는게 뭔지 한번 알아보겠다.
Discriminative vs. Generative 구별 대 생성 모델
간단하게 구별 모델과 생성 모델을 짚고 넘어가자.
- 구별 모델은 입력-->출력의 관계를 알아내는 것이 목적이다. 즉, 조건부 확률 p(y|x)을 추정하자는 것.
- 생성 모델은 더 일반적인 입력과 출력의 관계를 알아내려는 모델이다. 즉 p(x, y)을 추정하자는 것. p(x, y)를 알면 당연히 p(y|x)도 알아낼 수 있을 뿐만 아니라 더 재밌는 일을 할 수 있다. 예를 들어 새로운 (x, y) 데이터를 생성할 수 있고, 그래서 이름이 생성 모델이다. 더 강력한 정보를 필요로 하는 만큼 더 어렵다.
Generative Adversarial Networks

(그림 출처: https://ishmaelbelghazi.github.io 라고 나오는데 이 블로그가 사라짐..)
위의 그림이 GAN의 구조다. 간단하지요! 그야 간단히 그렸으니까 그렇고, 저기에서 보통 discriminator (구별망)와 generator (생성망)가 여러 층의 신경망로 이루어진 경우가 대부분이다. 대부분의 연구가 이미지를 다루고 있고, 그래서 두 신경망도 컨브넷인 경우가 많다. 자, 핵심은,
GAN의 핵심은,
- 생성망은 최대한 실제 데이터와 비슷한 데이터를 생성해내려고 하고
- 구별망은 열심히 그 둘을 구별하려고 한다는 것
이다. 이를 원문에서는 minimax two-player game이라고 표현했다.
수식으로는 아래처럼 표현한다.

- arg max D: 여기에서는 목적함수를 극대화하는 분류망 D를 찾는다
- 첫번째 항 E[Log D(x)]은 실제 데이터 (x), 예를 들어 진짜 그림을 넣었을 때의 목적함수의 값이다.
- 두번째 항 E[log(1-D(g(z)))]은 가짜 데이터 (G(z)), 즉 생성망이 만들어낸 그림이 들어가있다. 그리고 arg max D인데 항 내부는 1-D(G(z))이다. 다시 말해 둘째 항의 극대화는 D(G(z))의 극소화다.
- 결과적으로, 이 두 항의 목적함수를 이용해
- 진짜 그림을 넣으면 큰 값을,
- 가짜 그림을 넣으면 작은 값을
- ..출력하도록 구별망 D를 열심히 학습시키자는 것이다.
- arg min G: 이 말은 목적함수를 극소화하는 생성망 G를 찾자는 이야기다.
- G는 두번째 항에만 포함되어있다.
- 전체 함수를 극소화하는 G는, 둘째 항을 극소화하는 G이고, 결국 D(G(z))를 극대화하는 G이다.
- 결과적으로, 구별망을 속이는 생성망 G를 열심히 학습시켜보자는 이야기다.
코드
 def generator(input, hidden_size):
   h0 = tf.nn.softplus(linear(input, hidden_size, 'g0'))
   h1 = linear(h0, 1, 'g1')
   return h1
 def discriminator(input, hidden_size):
   h0 = tf.tanh(linear(input, hidden_size * 2, 'd0'))
   h1 = tf.tanh(linear(h0, hidden_size * 2, 'd1'))
   h2 = tf.tanh(linear(h1, hidden_size * 2, 'd2'))
   h3 = tf.sigmoid(linear(h2, 1, 'd3'))
   return h3
각각 생성망과 구별망이다. 여기에서 중요한 내용이 언급되었다. 생성망보다 복잡하게 구별망을 짜야한다!
사실은 아래 코드가 핵심이다.
 with tf.variable_scope('G'):
   z = tf.placeholder(tf.float32, shape=(None, 1))
   G = generator(z, hidden_size)
 with tf.variable_scope('D') as scope:
   x = tf.placeholder(tf.float32, shape=(None, 1))
   D1 = discriminator(x, hidden_size)
   scope.reuse_variables()
   D2 = discriminator(G, hidden_size)
 loss_d = tf.reduce_mean(-tf.log(D1) - tf.log(1 - D2))
 loss_g = tf.reduce_mean(-tf.log(D2))
아래 두 줄이 각각 구별망과 생성망에 arg max D, arg min G를 구현한 부분이다. loss를 감소하도록 학습되기 때문에 loss_d는 위에서 소개한 식과 부호가 반대다.
결과
보강
위의 영상을 보면 결과가 조금 아쉬운데, 이에 대해 https://arxiv.org/abs/1606.03498에서 해결 방법을 소개했다. 미니배치를 써라! 구별망이 한번에 여러 샘플을 보게 하라는 내용이다. 그 외에도 몇 가지 방법이 있는데 실제로 써본적이 없으므로 원문을 참고하면 된다.
그 결과는? 아래처럼 더 잘된다.
------
번역은 여기까지입니다. 우리모두 열공!
Monday, December 5, 2016
음성/음악신호+머신러닝 초심자를 위한 가이드 [3편]
음성/음악신호+머신러닝 초심자를 위한 가이드 전체 게시물은 여기를 클릭하세요.
서문
가이드 3편입니다. 기존 가이드는 1편, 2편을 참고하세요.모 대학원의 모 분께서 음악 신호와 머신러닝에 대한 질문을 주셨는데 중요한 점을 콕콕콕콕콕콕 집어서 물어보셔서 블로그에 글을 쓰기로 했습니다.
질문-답변 1
음악 인식쪽이 생소하다 보니 일단 먼저 music genre classificaiton(음악,음성신호 입력 --> [전처리] --> [특징값 추출] --> [분류기] --> 결과) 를 주제로 toy porject를 해보려고 합니다. 툴은 librosa를 쓸 예정입니다.
궁금한 점이 몇가지 있는데
1) 혹시 mp3파일이 주어졌을때 전처리를 하고 특징값 추출을 하는 하는 소스코드가 있으시면 공유 가능한가요?
2) 제 계획은 librosa가 제공하는 여러개의 특징을 최대한 많이 사용하고 후에 PCA등으로 후처리를 하려고 하는데, librosa가 제공하는 특징 (http://librosa.github.io/librosa/feature.html)중에 음악 분류에 적합한 특징에는 어떤 것이 있을까요?
궁금한 점이 몇가지 있는데
1) 혹시 mp3파일이 주어졌을때 전처리를 하고 특징값 추출을 하는 하는 소스코드가 있으시면 공유 가능한가요?
- 상황에 따라 다르지만 대체로 추출과정은 https://github.com/fchollet/keras/blob/master/keras/applications/audio_conv_utils.py#L27 을 참고하시면 됩니다.
여기에서는 mel-spectrogram만 뽑는데, 여기에 다른 추출기를 추가하시면 되겠습니다.
2) 제 계획은 librosa가 제공하는 여러개의 특징을 최대한 많이 사용하고 후에 PCA등으로 후처리를 하려고 하는데, librosa가 제공하는 특징 (http://librosa.github.io/librosa/feature.html)중에 음악 분류에 적합한 특징에는 어떤 것이 있을까요?
- MFCC는 필수고, 그 외에 spectral-시리즈와 zero-crossing + tempo (http://librosa.github.io/librosa/generated/librosa.beat.estimate_tempo.html) 등을 쓰시면 됩니다.
그리고 특징값 추출 전에 http://librosa.github.io/librosa/generated/librosa.decompose.hpss.html 을 사용하셔서 두 채널을 따로 하시면 도움이 될겁니다.
질문-답변 2
지난번에 말씀하신데로 간단한 특징 추출 과정을 수행해보고 있는데, 몇가지 궁금한점이 있습니다.
1) https://github.com/fchollet/keras/blob/master/keras/applications/audio_conv_utils.py#L27 을 참고하라고 하셔서 소스코드를 살펴봤습니다. 보통 음악 파일들은 3분이상이며, 제각기 길이가 다른데 소스코드에서 음악 파일의 가운데 DURA = 29.12 초 구간만을 프로세스 하더라고요. 이렇게 하는 이유는 각 음악 파일 별로 길이(재생 시간)가 다르지만 같은 크기(차원)의 특징 벡터를 얻기 위함인가요? 그리고 가운데 29초만으로도 충분한 정보가 있다고 가정하고 처리하는건가요? 끝으로 이렇게 가운데 구간을 trim 하는 기법이 일반적인 기법인가요?
- 이유: 맞습니다. 시간에 따른 정보를 어떻게 합치느냐에 따라 다르겠지만 링크의 컨브넷은 입력 신호의 길이를 29.12초로 제한하고 있습니다. 이보다 짧은 경우에는 나머지를 0으로 채워서 입력으로 넣어도 무방하지만 긴 경우에는 적당한 구간을 잘라줘야합니다. 그리고 말씀하신대로 가운데 29초가 충분한 정보가 있다고 가정하는 것입니다. 물론 상황에따라 다를테고, 제가 논문에서 사용한 음원은 기본적으로 30-60초의 '미리듣기'용 음원입니다. 이런 경우엔 사실 어디를 사용하더라도 무방하겠죠.
가운데를 사용하는건 아무래도 가장 단순하고 그러면서도 적당히 작동하는 방법입니다. 그 외에도 대중 가요의 경우 60-120초 사이에 하이라이트 (혹은 chorus, 혹은 싸비..)가 있다고 가정할수도 있구요. 이 외에도 가장 중요한 구간을 뽑아주는 방법를 여러가지로 생각해볼 수 있겠죠. 간단한 방법으로는 frame별로 energy를 계산해서 평균 에너지가 제일 높은 30초를 뽑을수 있겠죠. 보다 복잡한 방법으로는 음악 내 다양한 구간을 잘라주는 알고리즘을 사용한 뒤에 어디가 하이라이트인지 뽑을수도 있구요. 이는 원하시는 성능과 연산량에 따라 결정하시면 됩니다.
2) 음성/음악신호+머신러닝 초심자를 위한 가이드 [2편]을 보면, 프레임 마다 특징값을 뽑는 것이 아니라 오디오 신호 전체를 표현할 특징값을 찾기 위해 평균 및 분산 MAX를 뽑는다고 하는데 혹시 관련 논문 아시면 제목 알려주 실 수 있나요?
그리고 1)질문과 연관지었을 때 제가 음악 처리를 할때, 음악 파일 1개의 전체 구간에 대해서 평균 분산을 구하게 되면 아무래도 정보가 많이 뭉개질것 같더라고요. 그래서 1)번의 코드처럼 아예 처음부터 가운데 구간이 충분히 의미 있다고 가정하고 29.12초의 짧은 구간만을 평균, 분산 등을 이용해서 오디오 레벨 특징을 뽑으려고 하는데 reasonable한 방법인가요?
http://dspace.library.uvic.ca:8080/bitstream/handle/1828/1344/tsap02gtzan.pdf?sequence=1 를 보시면 평균과 분산 등을 사용했습니다. 그 외에도 frame-based feature를 clustering하고 이를 기반으로 quantized count를 사용하는 방법(http://dawenl.github.io/publications/LiangZE15-ccm.pdf)도 있습니다.
그리고 가운데 구간만 사용하는것이 곡 전체를 사용하는 것보다 나을것이라는데 동의합니다.
3) 특징 추출 시 HPSS를 통해 2채널로 분리한 뒤 특징을 추출하라고 하던데, 예를들면 제가 LIBROSA에서 제공하는 특징들 중 A,B,C 를 추출하려고 한다면, 하나의 음원으로부터 각 채널별로 A,B,C를 추출해서 총 6개(3*2)의 특징을 구하라는 말씀이신가요? 예제들을 잘 보면 어떤 특징은 H채널에서 뽑고, 어떤 특징은 P채널에서 뽑더라고요. (https://github.com/librosa/librosa/blob/master/examples/LibROSA%20demo.ipynb)
말씀하신대로 Harmonic + Percussive에서 모든 특징을 다 뽑아도 큰 문제는 없겠지만 가장 relevant한 정보만 뽑는다고 한다면, 각 트랙에 맞춰서 특징값을 골라주는게 좋겠네요. 하모니나 pitch에 관련된 특징값(chroma-어쩌구, ) 은 harmonic 트랙에서 뽑고, rhythm/onset/tempo 등은 percussive 트랙을 이용하시구요. spectral_어쩌구; (spectral centroid, ..)가 좀 애매한데, 얘네들은 분리하기 전 채널을 이용해 추출하는 것이 좋아보입니다.
4) 종종 특징들을 뽑고 아래와 같이 LOG화 시키던데 이렇게 하는것이 일반적인 방법이며, 인식 향상에 도움이 되나요?
# Convert to log scale (dB). We'll use the peak power as reference.
log_S = librosa.logamplitude(S, ref_power=np.max)
네. 우선 STFT/CQT/Melgram등의 time-frequency representation은 log()를 씌워 데시벨 스케일로 바꿔주는것이 좋습니다. (그 외에도 일반적인 머신러닝에서 하듯 zero-mean unit-variance로 standardisation을 해주는것이 좋을테구요.) 이런 전처리는 인식 향상에 도움이 됩니다.
5) 음악 인식 분야에서도 CNN을 이용한 기법들이 도입되고 있다고 들었는데, 보통 CNN의 input 은 주로 어떻게 처리해서 주나요? 그리고 혹시 관련 논문을 알려주실 수 있나요?
여러가지 경우가 있습니다.
Pitch와 관련된 정보 추출: CQT를 사용하고 대역폭을 음의 fundamental frequency가 분포할 수 있는 영역으로 제한한다. (대략 30Hz - 3kHz정도가 되겠죠)
리듬관련: STFT나 Mel-spectrogram을 사용한다.
풀고자 하는 문제가 사람의 musical perception에 관련된 경우 (예: 감정 인식): Mel-spectrogram을 우선적으로 고려하고 STFT도 가능하면 테스트해본다. 주파수 대역은 대략 4kHz - 11K를 고려한다.
잘 모름: 8kHz나 16kHz로 샘플링하고 STFT (n_fft=1024 또는 512)와 Mel-spectrogram (128 bins)를 써본다.
음악이 아니라 음성이 입력이다: Mel-spectrogram을 최우선적으로 고려한다.
음악, 음성이 아니라 '소리'에 관련된 작업이다: STFT를 사용하고 Mel-spectrogram을 고려해본다.
그리고 이와 관련된 논문은 아직 없습니다. 제가 대략 2-4개월내로 하나 작성하려고 계획중입니다.
6) 제가 앞으로 해보려는 것은 일단 음원이 주어지면 고정 길이로 음원 구간을 trim 시키고, 이 구간에 대해 여러개의 특징벡터를 추출하려고 해요. 이렇게 하면, 음원에 대해서 (프레임 개수) X (프레임당 특징 벡터들의 차원의 합)의 행렬이 만들어 질텐데, 음악 장르를 구분하는 task라고 가정하고 CNN 의 input으로서 이 이차원 행렬 그대로 주는게 좋을까요 아니면 2)에서 언급한것처럼 이 2차원 행렬의 프레임별 평균, 분산등을 구해서 1차원 벡터로 차원을 축소 한 뒤 입력으로 주는 것이 좋을까요?
데이터 개수가 충분히 많다면 2차원 데이터를 쓰시고, 그렇지 않으면 1차원 벡터로 입력 데이터의 크기를 줄여야겠죠. 장단점이 있어서 해보기전엔 정하기 어려워보입니다.
Tuesday, September 6, 2016
논문 요약 - Deep Neural Networks for YouTube Recommendations
원문은 구글 리서치 블로그 (논문 pdf)입니다. 조만간 보스턴에서 열리는 2016 RecSys 논문인데 최근에 구글 리서치 홈페이지에 올라오고 나서 학계에서 주목을 많이 받았습니다.


1. 서문
- 세 가지 중요한 잣대: Scale, Freshness, Noise
- Scale: 데이터가 매우 많으므로 scalability가 중요하다.
- Freshness: 새로운 비디오가 추가되었을때 추천에 바로바로 반영되어야 한다.
- Noise: 데이터의 sparsity, ground truth의 부재, 거의 항상 implicit feedback만 갖고있다, meta data가 엉망인 점 등을 고려해야함.
- 구현
- Tensorflow를 사용함
- 전체 시스템은 10억개정도의 파라미터 존재
- 트레이닝 데이터는 수천억개정도.
2. 시스템 개요

- 전체 구조는 (파란 블럭)
- 단계 1: 추천할 후보 비디오를 몇 백개 내외로 뽑아내고
- 단계 2: 다시 그 중에서 자세하게 순위를 매겨서 추천
- 이 과정에서 사용자의 이용 내역과 맥락을 감안합니다.
- 개발 과정은
- precision/recall/ranking loss등 offline에서 측정 가능한 것들을 일단 측정해서 어느정도 범위를 줄이고
- watch time, click-through rate은 A/B test를 거친다.
- A/B test 결과 (실시간 피드백)가 항상 offline 실험 (전체 히스토리를 retrospective하게 보고 평가하는것)과 일치하진 않는다.
3. 단계 1: Candidate generation
- 기존에는 Ranking loss를 이용한 Matrix factorisation [23]을 사용
- MF를 대체하기 위해 간단한 뉴럴넷을 사용한적 있었으며 이때는 사용자가 과거에 본 비디오 내역만 이용했었다.
3.1 Recommendation as classification
- 문제 정의
- 추천: 엄청나게 클래스가 많은 multiclass 분류 문제로 재정의 (Extreme multiclass classification)
- user, context가 주어지면 특정 시간에 이 비디오를 볼 확률을 구함. 즉,

- v_j : context embedding
- u: user embedding
- 이 학습 과정에서 사용자가 누른 '좋아요' 같은 정보는 사용하지 않고 비디오를 끝까지 봤는지/아닌지만 사용.
- Extreme multiclass classification 효율적으로 어떻게 구현?
- Offline에서는 (즉, 미리 계산)
- negative class를 샘플링 (i.e., skip-gram negative sampling)
- loss function으로는 각 class (비디오)마다 (binary) cross-entropy를 사용
- 대략 수천개정도의 negative sample 이용
- hierarchical softmax는 (이런저런 이유로) 사용하지 않음.
- at serving time (추천을 실시간으로 할때는)
- 드디어 사용자에게 추천을 N개의 비디오를 고르는 시간
- 기존에는 [24]처럼 hashing을 사용했고 이번에도 마찬가지.
- 최종적으로는 (위의 식처럼) dot-product space에서 가장 가까운 아이템 (nearest neighbour)를 찾는 과정.
- A/B test 결과 nearest neighbour 알고리즘간에 추천성능 차이는 없음
3.2 구조
- 사용자가 본 영상 내역을 embedding vector (좌측하단 파란색)로 바꿈
- 여러 영상의 embedding vectors를 평균내서 사용. (sum, component-wise max 등 사용해봤으나 평균이 제일 좋음)
- Fully-connected layer + ReLU 사용

3.3 Heterogeneous signals
- 개요
- 검색 내역 (그림의 하단 초록색)도 영상처럼 embedding을 구함
- 그 외에 사용자의 지역정보/기기 등 간단한 정보도 embedding을 구하고 이 값을 concatenate함.
- 성별, 나이 등 값은 [0, 1]로 바꿔서 넣음.
- "비디오의 나이" (example age)
- 새로 나온 비디오를 잘 보여주는것이 중요하다.
- 사용자가 얼마나 새로운 비디오를 선호하는지도 중요
- 트레이닝 데이터 특성상 머신러닝을 단순하게 적용하면 오래된 아이템들이 더 추천을 많이 받게 된다.
- 이를 해결하기위해 아이템(비디오)의 "나이"를 입력으로 넣어준다.
- 위의 그래프를 보면 아이템의 나이를 넣어주면 (빨강색) 업로드 직후에 사람들이 많이 감상하는 경향을 예측하고 있다.

3.4 Label and context selection
- 추천은 전형적인 "Surrogate problem"이다. -- 다른 문제를 통해 추천 문제를 해결할 수 있다.
- 예를 들어 영화 평점 예측 알고리즘은 영화 추천에 사용 가능.
- 그러면 유튜브에선 어떤 문제를 이용해야하는가?
- 학습 데이터: 잘못 만들면 추천엔진이 exploit >> explore 하게 된다.
- 유튜브 웹사이트를 통해 본 내역 말고도 온갖 소스를 통해 본 이용 내역을 전부 활용한다. 왜냐하면 유튜브에서 이미 추천 시스템이 있으므로 유튜브 웹사이트에서 감상한 비디오는 이미 추천 시스템의 결과에 치우친 데이터를 만들어내기 때문에.
- 데이터에서는 이용자별 영상 감상 횟수를 제한한다. 엄청나게 많이 보는 사람들의 영향을 빼기위해.
- 또, 추천 결과나 검색 결과를 즉시 활용하지 않는다.
- 검색 키워드는 일부러 순서를 날린 bag-of-tokens을 이용한다.
- 안그러면 방금 검색한 내용이 계속 메인 페이지에 떠서 짜증남.
- 유튜브 영상 감상 패턴: 매우 비대칭적이다.
- 비대칭적인 co-occurrence (or co-watch)
- 즉, 영상 감상은 순서가 정해져있음.
- 에피소드가 1-2-3-4.. 진행되는 경우는 물론이고,
- 음악의 경우에도 유명한 노래 --> 마이너한 노래로 가는 경향.
- 이 비대칭을 모델링하려면 offline 실험에서도 "과거"의 자료만 사용해야함 (그림 5-b)
- 실험결과 - feature and depth

- Offline에서 MAP 측정
- baseline: 감상 내역만 이용
- 파랑색: 감상내역 + 검색
- 빨강색: 감상내역 + 검색 + 영상의 나이
- 초록색: 전부 다 이용
- 실험은 영상 100만개, 검색어 100만개를 256차원의 embedding으로 변환. bag_size는 최근 50개 영상/검색
- depth 깊어질수록 성능 좋아짐.


4. 단계 2: 랭킹
여기에서는 더 많은 feature를 이용해 영상과 이용자의 관계를 구한다.
역시 deep neural network를 이용.

그리고 이 구조는 A/B test를 통해 계속 업데이트됨. 평가 잣대는 추천된 횟수 (=화면에 뜬 횟수) 대비 평균 감상 시간.
4.1 Feature representation
- 여기에서는 딥러닝을 통해 학습된 feature뿐만 아니라 hand-written feature를 사용.
- 대략 수백개정도의 feature 사용.
- 사용자의 이용패턴 - 특히 여러 종류의 정보가 어떻게 관계를 맺고있는지가 중요. 예를 들어,
- 이 채널에서 이 이용자가 몇 개나 되는 영상을 봤는지
- 마지막으로 이 주제의 영상을 본게 언제인지..
- 또, 왜 이 영상이 추천되었는지 정보도 활용한다.
- 또또또, 추천했는데 안보는 영상은 조금씩 순위를 깎는다.
- categorical features
- Top-N 영상 및 검색어를 embedding한다.
- 그 외의 것들은 0으로 놓는다.
- 영상 id, 사용자가 마지막으로 본 영상 id, 이 추천에 사용된 seed 영상 id 등을 전부 사용한다.
- 얘네들은 평균을 구하거나 하는게 아니라 별도로 network에 들어간다. [왜냐하면 다른 역할을 해야하니까!]
- continuous features 처리방법
- 값 x를 [0, 1]에 들어오도록 scaling해주고,
- x, x**2, sqrt(x) 를 다 넣어준다.
- 왜냐면 딥러닝은 입력 데이터의 pre-processing에 매우 민감한데 어떤 값이 가장 좋은지 알기 어려우므로. [이렇게 넣어주면 별도의 layer를 통해 제곱, sqrt()등의 비선형성을 학습하지 않아도 단일 레이어에서 가중치만 잘 주면 됨.]
4.2 Modelling expected watch time
- 감상시간: 안보면 0으로, 보면 본 시간대로 값을 넣어준다.
- (새로 정의한) weighted logistic regression을 사용한다.
- 감상한 영상을 감상 시간으로 가중치를 주는 것.
- 실험 결과
- (당연히) 더 크고 깊은 신경망이 작동을 더 잘함. 실제 상황에서는 서비스의 반응 시간이 느려질 수 있다는점 주의.

5. 결론
- 요 방법이 Matrix factorisation보다 좋다.
- 전체 시스템을 디자인하는건 거의 과학이 아니라 예술임.
- "영상의 나이"가 잘 작동한다.
- 단계 2의 세부 튜닝은 딥러닝보다는 전통적인 ML에 더 비슷하다.
- 특히 사용자의 과거 행동 패턴을 잘 설명하는 feature가 중요
- weighted logistic regression을 쓴것이 click-through rate을 쓴것보다 결과가 좋다.
Tuesday, August 9, 2016
세상에 있는 (거의) 모든 머신러닝 문제 공략법
좋은 블로그 게시물이 나와서 번역합니다. 원문은 이곳을 참고하시기 바랍니다.
Karpathy의 글도 그랬지만 그림은 그대로 퍼오고, 글도 가급적 그대로 번역합니다. 교육 목적으로 활용해주시길 바랍니다.
제가 보충 설명을 하는 경우엔 괄호안에 (**요렇게) 적어놓았습니다.


Karpathy의 글도 그랬지만 그림은 그대로 퍼오고, 글도 가급적 그대로 번역합니다. 교육 목적으로 활용해주시길 바랍니다.
제가 보충 설명을 하는 경우엔 괄호안에 (**요렇게) 적어놓았습니다.
세상에 있는 (거의) 모든 머신러닝 문제 공략법 (Approaching (Almost) Any Machine Learning Problem)
저자: Abshshek Thakur
번역: 최근우
데이터 사이언티스트들은 하루종일 데이터를 다룹니다. 사람에 따라 다르겠지만 60-70%의 시간을 데이터를 전처리하고 원하는 형태로 변환하는데 사용한다는 사람도 있습니다. 그런 과정이 끝나고 나면 실제로 데이터에 머신러닝 알고리즘을 적용합니다. 이 글에서는 간단한 전처리 과정 및 머신러닝을 적용하는 과정을 자세히 다룹니다. 여기에서 소개하는 파이프라인은 제가 백개가 넘는 머신러닝 대회에 참가한 경험을 바탕으로 배운 내용입니다.
파이썬을 사용해 설명드리겠습니다.
데이터
머신러닝을 활용하려면 데이터를 테이블의 형태로 변환해야합니다. 이 과정은 시간도 오래걸리고 힘든 과정입니다.

이 테이블의 각 행(row)은 각각의 데이터 샘플에 해당합니다. 보통 입력 데이터를 X, 레이블 (혹은 출력)을 y로 표현합니다. 레이블은 하나의 열(single column)일 수도 있고 여러 열로 이루어져 있을 수도 있습니다.
레이블의 종류
- 단일 열, 이진수 (분류 문제. 레이블엔 두 개의 카테고리가 존재하고 모든 데이터 샘플은 반드시 둘 중 하나의 카테고리에만 해당하는 경우. 0과 1로 각각 다른 카테고리를 표현할 수 있으므로 이진값을 사용한다.)(**예: 텍스트를 보고 저자의 성별을 맞추는 경우)
- 단일 열, 실수 (회귀 문제. 단일 열이므로 단 하나의 값만 예측하면 된다.)(**예: 텍스트를 보고 저자의 나이를 예측하는 경우)
- 여러 열, 이진수 (분류 문제. 여러 카테고리가 존재하고 각 데이터는 하나의 카테고리에 해당한다.)(**예: 댓글을 보고 작성자가 응원하는 스포츠 팀을 맞추기, 이 경우에 열의 개수는 스포츠 팀의 개수와 같다.)
- 여러 열, 실수 (회귀 문제이나 여러 값을 예측함.)(**예: 의료 검진 데이터를 보고 피검사자가 여러 종류의 암에 걸릴 확률을 예측. 이 경우 열의 개수는 암 종류의 개수와 같다.)
- 다중 레이블 (분류 문제, 각 데이터 샘플이 여러개의 카테고리에 속할 수 있다.)(**예: 음악 신호를 보고 드럼, 기타, 보컬이 있는지 여부를 판단하는 경우. 열의 개수는 3개가 된다.)
평가 방법
어떤 경우든지간에 머신러닝 알고리즘의 평가는 필수입니다. 각 카테고리의 데이터 개수가 크게 차이나는 경우에 ROC AUC를 사용할 수도 있고, 다중 레이블 분류 문제는 카테고리 크로스 엔트로피나 다중레이블 로그 로스 등을 활용합니다.
평가 방법은 상황에 따라 다르기 때문에 여기에선 자세히 다루지 않습니다.
라이브러리
필수적인 라이브러리를 몇 가지 소개합니다.
- 데이터를 보고 간단한 연산을 수행: pandas
- 각종 머신러닝 모델: scikit-learn
- 최강의 그라디언트 부스팅 라이브러리: xgboost
- 뉴럴 네트워크: keras
- 데이터 시각화: matplotlib
- 실시간 모니터링: tqdm
아나콘다를 사용해 다양한 라이브러리를 쉽게 설치할 수 있습니다. 저는 사용하고있지 않지만 각자 판단하시길 바랍니다.
머신러닝 프레임워크

2015년부터 제가 개발중인 머신러닝 자동화 프레임워크의 그림입니다. 이 글에서도 그림과 같은 구조로 작업을 수행합니다.
가장 일반적으로 적용되는 단계를 진한 분홍색 화살표로 그렸습니다. 우선 앞에서 이야기한 전처리 과정을 거쳐 표 형태로 데이터를 정리하고나면 이 단계를 시작할 수 있습니다.
전처리
우선 우리에게 주어진 문제가 어떤 문제인지 파악해야합니다. 이진 분류(0 vs 1)인지, 여러 카테고리중 하나를 고르는 다범주 분류(multi-class classification)인지, 다중 레이블 분류문제인지 아니면 회귀 문제인지를 명확하게 결정해야합니다. 그리고 나면 우리가 가지고 있는 데이터를 학습 셋(training set)과 검증 셋(validation set)으로 나눕니다. 아래 그림을 참고하시길 바랍니다.

(**중요) 두 셋으로 나눌 때에는 반드시 레이블 정보를 사용해야합니다. 분류 문제의 경우 stratified splitting을 사용하시기 바랍니다. 파이썬에선 scikit-learn을 사용하면 됩니다. (**이렇게 하면 두 셋에서 레이블의 분포가 동일하게 유지됩니다.)

회귀 문제의 경우 그냥 간단하게 K-fold로 셋을 나눠주면 됩니다. 회귀에서도 분포를 유지하는 방법이 있긴 한데 독자여러분이 생각해보시길 바랍니다. (**아니 저기..)

이 코드에서는 검증 셋의 크기를 전체의 10%로 설정했습니다. 이 값은 가지고 있는 데이터의 크기에 따라 적절히 설정하면 됩니다.
이렇게 데이터를 나눈 뒤에는 두 셋을 동일하게 처리해야합니다. 그리고 절대 학습 셋과 검증 셋에 데이터가 겹치면 안됩니다. 그렇게 할 경우 마치 학습이 아주 잘 된 것 처럼 착각할 수 있습니다. 실제로는 엄청난 과적합(overfitting)이 일어나겠죠.
다음 단계는 데이터에 어떤 형태의 값이 있는지 알아내는 것입니다. 대략 숫자, 범주 정보, 그리고 문자열 데이터정도로 나눠서 생각할 수 있습니다. 카글의 타이타닉 데이터셋을 살펴볼까요?

여기에서는 survival이 레이블이 됩니다. 그리고 각 승객의 좌석 등급, 성별, 탑승한 항구는 범주화해서 생각할 수 있습니다. 나이, 형제자매의 수, 부모/자녀 등은 숫자 정보가 되구요. 마지막으로 이름은 문자열입니다. 이 작업 (**생존 여부를 예측하는 작업)에서는 크게 중요하지 않을 것 같군요.
우선 숫자를 봅시다. 이 값은 특별한 전처리 필요없이 바로 사용할 수 있습니다. 따라서 정규화(normalization) 및 머신러닝 기법을 바로 적용하면 됩니다.
범주 데이터는 두가지 방법으로 처리할 수 있습니다.
- 카테고리를 라벨로 변환

- 카테고리를 이진 변수 (one-hot-vector)(**하나의 성분만 1이고 나머지는 0인 벡터)로 변환

여기서 OneHotEncoder를 쓰기 전에 우선 LabelEncoder를 적용해야 하는 점을 주의하시기 바랍니다.
타이타닉 데이터셋의 문자열은 문자열 변수의 예로는 별로 좋지 않습니다. 일반적으로 문자열을 어떻게 다루는지 한번 알아보겠습니다.
우선 (**pandas를 쓸 경우) 아래 코드를 써서 데이터에 있는 모든 텍스트를 하나로 이어 붙일 수 있습니다.

그리고 여기에 CountVectorizer 또는 TfidfVectorizer를 사용합니다.


보통 TfidfVectorizer가 더 잘 작동합니다. (**당연히.. ) 대체로 아래처럼 셋팅하면 무난하게 사용 가능합니다.

만일 이 Vectorizer를 트레이닝 데이터에만 적용했다면, 나중에 사용할 수 있도록 하드디스크에 저장을 해놓아야합니다.

이제 Stacker 모듈을 봅시다. 여기에서는 다양한 특징값을 합칩니다.
일반적인 데이터는 np.hstack으로 벡터를 이어주면 됩니다.
만일 데이터가 sparse한 경우 (대부분의 값이 0인 경우) scipy.sparse를 사용합니다.

만일 PCA같은 과정이 포함되어있다면 sklearn.pipeline.FeatureUnion을 쓰면 됩니다.

자, 드디어 데이터 전처리가 끝났습니다.
이제 머신러닝 알고리즘을 적용하면 됩니다.
머신러닝 적용
어떤 모델을 적용할까요? 위의 단계를 밟은 경우엔 트리 기반의 알고리즘만 가능합니다. 트리 기반의 모델은 여러가지 종류가 있습니다.
- RandomForestClassifier
- RandomForestRegressor
- ExtraTreesClassifier
- ExtraTreesRegressor
- XGBClassifier
- XGBRegressor
선형 모델을 사용하려면 위의 특징값을 Normalize하는 과정을 거쳐야합니다. sklearn의 Normalizer나 StandardScaler를 사용하면 됩니다. 단, 데이터가 dense한 경우에만 사용이 가능합니다. Sparse한 경우엔 결과가 좋지 않습니다.
위의 트리 모델을 사용해서 그럭저럭 괜찮은 결과가 나왔다면 이제 모델을 자세하게 튜닝할 차례입니다.
다음 단계는 decomposition 입니다.
여기에선 LDA와 QDA는 생략합니다. 고차원 데이터의 경우 PCA(주성분분석)를 쓰면 차원을 효과적으로 줄일 수 있습니다. 이미지의 경우 10-15개의 성분을 사용해보고 차원을 늘려가며 성능을 비교해보십시오. 그 외엔 50-60개정도의 성분으로 시작해보십시오. 단, 값을 그대로 사용해도 괜찮은 상황이라면 굳이 차원을 줄일 필요는 없습니다.
텍스트의 경우는 sparse 행렬에 SVD를 적용합니다.

보통 120-200정도의 값을 사용합니다. 이보다 큰 값을 쓴다면 연산량에 유의하십시오.
이제 선형 모델도 사용할 수 있도록 특징값을 normalize하거나 re-scaling합니다. (**특징값의 범위를 조절) 그리고 나면 유용한 특징값을 고르는 Feature Selector 단계로 들어갑니다.

특징값을 선정하는 방법은 여러가지가 있습니다. Greedy 알고리즘을 쓸 경우엔, 우선 하나의 특징값을 골라서 모델을 돌리고 여기에 다른 특징값을 더하거나 빼면서 결과를 비교합니다. AUC로 모델을 평가하면서 특징값을 고르는 코드를 참고하십시오.
아래의 코드는 RandomForest를 이용한 예제입니다. 이렇게 학습한 모델을 저장해놓고 나중에 사용할 수도 있습니다.

n_opimators 등의 하이퍼파라미터를 너무 크게 설정하면 과적합(overfitting)이 일어나니 주의하십시오.
혹은 xgboost를 사용할 수도 있습니다.

데이터가 sparse한 경우에도 RandomForestClassifier, RandomForestRegressor, xgboost 등을 사용 가능합니다.
그 외에도 chi-2로 특징값 선택이 가능합니다.

여기에선 k를 20으로 설정했는데, 이 값 역시 하이퍼파라미터이므로 최적화가 필요합니다.
지금까지 여러 모델을 소개했습니다. 데이터를 처리할 때 이렇게 학습한 모델을 꼭 저장해놓으십시오.
모델 선택 및 최적화
이제 모델을 선택하고 하이퍼파라미터를 최적화하는 일이 남았습니다.

널리 쓰이는 모델은 아래와 같습니다.
- 분류
- Random Forest
- GBM
- Logistic Regression
- Naive Bayes
- Support Vector Machines
- k-Nearest neighbors
- 회귀
- Random Forest
- GBM
- Linear Regression
- Ridge
- Lasso
- SVR
하이퍼 파라미터를 최적화하는 과정은 정해진 공식이 없습니다. 많은 사람들이 이와 관련해 질문을 합니다만 데이터와 모델에 따라 달라지기때문에 한마디로 말하기가 어렵습니다. 또, 몇 가지 팁이 있지만 경험이 많은 사람들은 이 비법을 숨기려고 하기도 합니다. 하지만 제가 알려드리겠습니다.
각 모델별로 어떤 하이퍼파라미터가 있는지 정리하면..
위의 값을 임의로 조합한 랜덤 서치를 추천합니다.
제 생각일뿐이지만, 위의 값을 기반으로 찾아본다면 충분할겁니다.
정리
마지막으로 학습 과정을 정리해보면..

그리고 학습 과정에서 저장한 각종 변환(transform)을 다시 불러와서 validation/test set에 사용해야겠죠?

마무리
위의 과정을 잘 따라하면 대체로 아주 좋은 성능을 얻을 수 있을 것입니다. 물론, 잘 되지 않는 경우도 있겠죠. 그러면서 배우는 것이니 열심히 해보시길 바랍니다.
Saturday, June 4, 2016
강화학습 튜토리알 - 인공 신경망으로 '퐁' 게임을 학습시키자 (Andrej Karpathy 포스트 번역)
강화학습에 관심만 많던 차에 Andrej Karpathy가 훌륭한 튜토리알을 썼네요. 꼼꼼히 읽어볼 겸 번역합니다. 원문은 http://karpathy.github.io/2016/05/31/rl/ 입니다.


심층 강화학습
최근에 강화학습이 큰 인기를 끌고있다. 최근 이슈가 된 연구는 게임 화면을 보여주는것 만으로 아타리 게임을 조작하도록 학습하는 것, 이세돌과 알파고의 바둑 대결, 로봇이 걷고 뛰는 과정을 학습하는 것 등이 있다. 나도 작년부터 강화학습에 관심을 갖기 시작했고 Richard Sutton의 책, David Silver의 강의, John Schulmann의 강의를 보았고 Javascript로 강화학습 라이브러리를 짜기도 했다. 여름엔 딥마인드의 DeepRL그룹에서 인턴으로 일했고 최근에 OpenAI에서 발표한 강화학습 벤치마크 도구 OpenAI Gym의 개발에도 살짝 발을 담궜다.
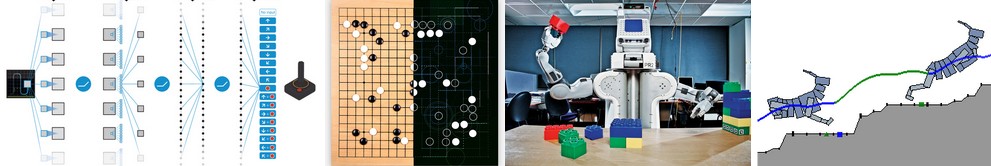
강화 학습에 대해 이야기할 내용이 많이 있다. 우선, 개인적으로 현재 인공지능 발전을 위해 해결해야할 문제를 아래 네 가지 정도로 보고있다.
- 연산량 (무어의 법칙 등)
- 데이타 (이미지넷처럼 잘 만들어진 데이타셋)
- 알고리즘 (backprop, 컨볼루션뉴럴넷, LSTM 등)
- 환경 (리눅스, git, AWS, TensorFlow 등 각종 소프트웨어)
컴퓨터 비전분야와 마찬가지로, 강화학습 역시 엄청나게 새로운 아이디어가 나타나서 이렇게 뜨고 있는것이 아니다. 2012년에 등장해 컨브넷의 시대를 연 알렉스넷은 대략 90년대의 컨브넷의 규모를 키운 버전이다. 마찬가지로 2013년에 소개된, 아타리 게임을 학습하는 Deep Q Learning은 함수 근사 (function approximator)로 컨브넷을 사용한 것을 제외하면 매우 일반적인 알고리즘이다 (함수 근사를 이용한 Q 학습은 1998의 Sutton 책에 소개된 내용이다). 알파고는 정책 그라디언트 (policy gradient)와 몬테-카를로 트리 탐색 (MCTS, Monte Carlo Tree Search)를 사용했는데 이 역시 널리 알려진 방법이다. 물론 이런 기본적인 방식이 이론상이 아니라 실제로 실험에서 잘 작동하게 하려면 각종 복잡한 기술을 동원해야한다. 하지만, 최근에 소개된 각종 연구의 일등공신은 알고리즘이 아니라 연산/데이터/환경이다.
다시 강화학습으로 돌아오자. 나는 정말 신기한 기술이 실제로는 엄청나게 단순한 원리로 작동하는걸 깨닫고 나면 블로그에 글을 쓰고싶어진다. 이 글의 경우엔 단 하나의 핵심 알고리즘과 게임 화면 정보를 주면 컴퓨터가 사람 수준으로 아타리 게임을 플레이할 수 있다는 놀라운 사실을 받아들이지 못하는 사람을 보며 글을 적어야겠다는 생각을 했다. 사실은 나도 선뜻 받아들이지 못했었다. 돌이켜보면 모든 것들이 다 그렇지만, 이 알고리즘도 정말 어이없을만큼 간단하다. 우선 여기서 독자들에게 정책 그라디언트 (Policy Gradient, PG)를 소개해주려고 한다.
PG는 현재 강화 학습에서 가장 흔하게 쓰이는 기법이다. 왜 Deep Q Network를 다루지 않느냐고? DQN이 강화 학습에서 제일 좋은 방법 아니냐고? 2013년에 처음 아타리 게임 논문에서 소개되었을 때엔 DQN이 최강의 알고리즘이라는 의견이 있었지만 현재 시점에서 보면 DQN보다 PG가 더 좋다. 실제로 대부분의 사람들이 PG를 선호한다. 심지어 DQN논문의 저자들도 잘 튜닝을 하면 PG가 DQN보다 더 좋다는 논문을 발표했다. 자 이제, 우리는 컴퓨터가 아타리 게임 중 Pong을 플레이할 수 있도록 PG를 이용해 학습시킬 계획이고 당연히 컴퓨터는 픽셀 정보만 사용한다. 이 예제는 Numpy만 이용해 130줄의 파이썬 코드로 되어있다.
PG는 현재 강화 학습에서 가장 흔하게 쓰이는 기법이다. 왜 Deep Q Network를 다루지 않느냐고? DQN이 강화 학습에서 제일 좋은 방법 아니냐고? 2013년에 처음 아타리 게임 논문에서 소개되었을 때엔 DQN이 최강의 알고리즘이라는 의견이 있었지만 현재 시점에서 보면 DQN보다 PG가 더 좋다. 실제로 대부분의 사람들이 PG를 선호한다. 심지어 DQN논문의 저자들도 잘 튜닝을 하면 PG가 DQN보다 더 좋다는 논문을 발표했다. 자 이제, 우리는 컴퓨터가 아타리 게임 중 Pong을 플레이할 수 있도록 PG를 이용해 학습시킬 계획이고 당연히 컴퓨터는 픽셀 정보만 사용한다. 이 예제는 Numpy만 이용해 130줄의 파이썬 코드로 되어있다.
화면을 보고 퐁을 배우자! (Pong from pixels)
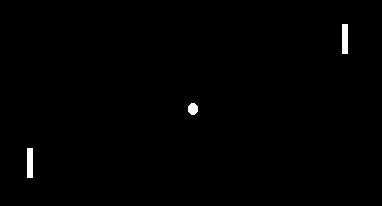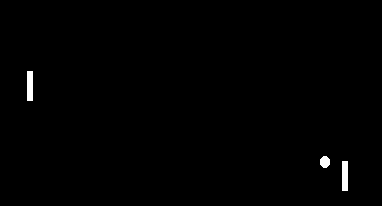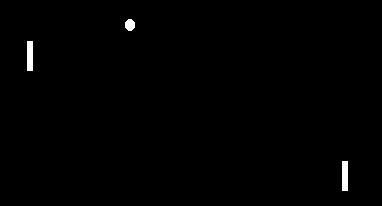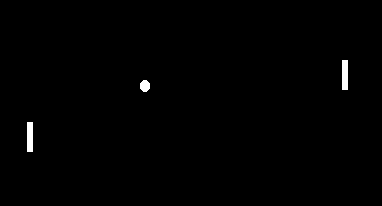
퐁은 간단한 강화 학습용 예제로 아주 적절한 게임이다. 아타리2600버전을 보면 위/아래 화살표로 막대기를 조절해 공을 받아낸다. 만일 공을 받아치지 못하면 패배한다는 규칙이다. 데이터 관점에서 보면 이렇다. 각 화면은 210x160 픽셀이고 RGB채널을 고려하면 210x160x3바이트의 데이터가 된다. 연속된 화면을 받게 되므로 실제 데이터는 210x160x3크기의 성분으로 이루어진 어레이가 된다. 이 데이터를 받고, 막대기를 위로 올릴지 혹은 아래로 내릴지를 판단하면 된다. 이렇게 내린 모든 판단은 나중에 피드백을 받게 된다. 만일 상대가 공을 받는데 실패했다면 +1의 보상을, 내가 공을 못받았다면 -1을, 둘 다 아니면 0의 보상을 받는다. 당연히 +1의 보상을 받것이 우리의 목표다.
중요한건, 실제로 퐁을 어떻게 플레이하느냐가 문제가 아니라는 것이다. 복잡한 데이터가 들어오고, 우리가 어떤 판단을 내려야 보상이 극대화가 되는지를 자동으로 학습하도록 한다는 그 설정이 중요하다. 퐁은 그냥 예제로 선정된 게임일 뿐이다.
정책망 (Policy Network)
우선 정책망을 우리의 선수(player) 혹은 요원 (agent)라고 정의하자. 정책망은 현재 게임의 상태가 어떤지를 입력으로 받고 이를 토대로 우리가 어떤 행동을 취해야하는지 (UP or DOWN; 막대기를 위로 올릴지 아래로 내릴지)를 판단한다. 데이터(화면)과 레이블(행동) 사이를 인공 신경망으로 이어주자. 여기에서는 층이 2개인 인공 신경망을 사용할 것이다. 여기에서 입력은 100,800 (210 * 160 * 3)개의 노드가 되고 최종적으로 UP이 될 확률이 출력이 될 것이다. 이 구성은 흔하게 쓰이는 Stochastic 정책이다. (어떤 선택을 내릴지의 확률을 구하는 경우 여기에 해당한다.) 학습 과정에서 우리는 이 확률 분포를 토대로 어떤 행동을 취할 것인지를 샘플링을 한다. 예를 들어 70%의 확률로 UP인 상황이라면 p(UP):p(DOWN) = 7:3인 동전을 튀겨서 나온 결과를 사용한다. 이렇게 하는 이유는 뒤에서 설명하겠다.
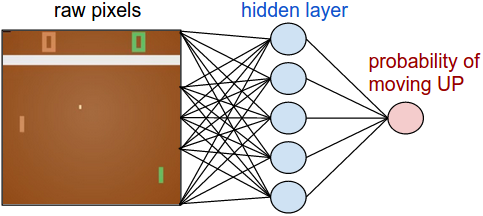
이 과정을 파이썬 코드로 쓰면 아래와 같다.
W1, W2는 임의의 값으로 초기화된다. Bias는 생략하자. 마지막 줄을 보면 sigmoid함수를 사용해서 결과 값이 [0, 1] 사이의 확률이 되도록 하는 것을 알 수 있다. 정리하면, 인공 신경망이 화면을 보고 게임 상황을 이해한 뒤 UP/DOWN중 무엇을 해야 하는지를 결정해주게 될 것이다. 학습 되기 전이라면 임의로 설정된 W1, W2가 어떤 판단이든 내릴 것이다. 자, 이제 학습을 통해 W1, W2가 의미있는 값이 되도록 - 즉 퐁을 플레이할 수 있도록 만들어주자!
팁: 전처리를 해야한다. 원래대로라면 적어도 2개 이상의 프레임 정보를 받아서 공의 움직임을 파악하게 해야한다. 여기에서는 연산량을 더 줄이기 위해 전 프레임과 다음 프레임의 차이를 입력으로 넣어주자.


하지만 반대의 경우도 굉장히 많다. 즉, 정책망을 사용한 방법이 사람을 쉽게 이기는 경우도 많이 있다. 특히 반응 속도가 굉장히 빨라야 한다거나 아주 까다로운 행동을 취해야 하는 경우에 정책망은 사람보다 훨씬 잘 할 수 있다.
이제 원리를 이해했으니 정책망을 이용한 강화학습의 장단점을 알 수 있다. 아직 인공지능은 사람처럼 복잡하고 추상적인 개념까지 이해하면서 작업을 수행하지는 않는다. 하지만 언젠가는 그런날이 올 것이다.

신경망에서 입력이 들어와서 어디를 볼지를 결정하는 과정을 간략히 나타낸 그림이다. 여기에서 대부분의 과정은 미분이 가능하지만 빨간색 화살표로 나타낸, 어디를 볼지를 '확률 분포에 의해 샘플링하는 과정'은 미분이 불가능하다. 따라서 backpropagation을 할 수가 없다.
정책망을 이용하면 이 문제를 해결할 수 있다. 위의 그림에서 샘플링하는 경우의 수를 3가지로 보고 나타내면 아래 그림처럼 된다. 학습 과정에서, 여러번의 샘플링이 일어나게 되고 실제로 샘플링의 결과를 따라서 backpropagation을 하면 된다. 이 과정은 Gradient Estimation Using Stochastic Computation Graphs에 잘 나와있다.

정책망을 쓰면 이를 효율적으로 해결할 수 있다 (RL-NTM 참조). 위의 여러 과정에서 샘플링을 했던 것 처럼, 메모리의 어디에 쓰기 연산을 수행할지 - 즉 변수 i - 를 샘플링하고 그 결과를 지켜보는 것이다. 실제로는, 수많은 메모리 위치 중에서 정확한 위치 i를 샘플링할 확률이 매우 낮기 때문에 이 방식은 경우의 수가 많은 상황에서는 적합하지 않다.
하지만 언젠가 아주 많은 연산과 데이터가 가능해지면 정책망을 통해 이 문제를 해결하게 될 수도 있다. 그리고 이 모든것이 더욱 더 발전하면 TCP/IP이나 컴파일러 등 복잡한 상황을 인공 신경망을 통해 해결하게 될 수도 있을 것이다.
그 외에도 경우의 수를 탐색하는 과정을 최적화 하는 다양한 시도가 있다. 예를 들어 알파고는 무작위 판단이 아니라 사람이 선택한 경우의 수를 기반으로 학습의 효율을 높였다. (역자 주: 이 문단 뒤쪽은 생략합니다)
정책망도 마찬가지다. 이 모든 과정은 완전 자동이 아니고, 데이터가 아주 많이 필요하고, 학습 과정이 엄청나게 오래 걸리고, 잘 작동하지 않는 경우엔 디버깅을 하기가 매우 까다롭다. 정책망을 적용하기 전에 먼저 Cross-entropy method를 베이스라인으로 구현해봐야한다. 그리고 나서도 정책망을 사용하려고 한다면 각종 책과 논문에 나온 나온 팁을 아주 자세히 보고, 아주 간단한 구성부터 시작을 해야한다. 그리고 일반적인 정책망보다는 약간 변형된 방법인 TRPO를 시도해보도록 해라. 대부분의 경우에 더 잘 작동한다고 알려져있다. TRPO의 핵심은 ...(역자 주: 제가 정확히 몰라서 이부분 생략합니다).
자, 이제 포스팅을 마친다. 이 포스팅으로 강화 학습에 대해 잘 이해했길 바란다. 강화 학습 연구에 더 본격적으로 참여하고 싶다면 OpenAI Gym을 활용하길 바란다.
h = np.dot(W1, x) # compute hidden layer neuron activations
h[h<0] = 0 # ReLU nonlinearity: threshold at zero
logp = np.dot(W2, h) # compute log probability of going up
p = 1.0 / (1.0 + np.exp(-logp)) # sigmoid function (gives probability of going up)
팁: 전처리를 해야한다. 원래대로라면 적어도 2개 이상의 프레임 정보를 받아서 공의 움직임을 파악하게 해야한다. 여기에서는 연산량을 더 줄이기 위해 전 프레임과 다음 프레임의 차이를 입력으로 넣어주자.
가능한가?
우선 강화 학습이 얼마나 까다로운 문제인지를 파악해보자. 입력 값으로 100,800개의 값을 받고 그 결과로 UP/DOWN을 결정해야 한다 (W1, W2의 크기는 대략 수백만개 이상일것이다). 어떤 시점(n)에, 판단이 UP으로 결정이 되었다고 가정해보자. 그리고 별 일이 일어나지 않아서 보상으로 0을 받고 다음 시점(n+1)이 되면 또 100,800개의 값이 (다음 화면이) 입력으로 들어온다. 또 이걸 하고, 이걸 수백번 반복하고 나면 어느순간 드디어 0이 아닌 보상을 받게 될 때가 올 것이다. 예를 들어 우리가 게임을 이겼고 (만세!) 그래서 +1의 보상을 받았다고 하자. 그런데, 그동안 반복한 수백번의 행동중에 어떤 행동이 승리에 결정적인 요인이 되었는지 판단할 수 있나? 마지막에 움직인건가? 아니면 76프레임 전에? 아니면 10프레임과 90프레임때? 그리고 수백만개의 가중치를 어떻게 바꿔야 좋을지 어떻게 구할 수 있나?
이 문제를 credit assignment problem이라고 부른다. 즉, 어떻게 공을 치하해야할지를 할당하는 문제이다. 진짜 결정적인 요인으로 우리가 공을 받아내기 어려운 곳으로 보낸 행동이 있을 것이다. 그리고 그 이후의 움직임은 승리에 전혀 도움이 되지 않는 행동이었다. 이걸 판단하는 문제는 언뜻 생각해도 쉽지 않다.
지도 학습 (Supervised learning)
PG를 하기 전에 잠시 지도 학습에 대해 알아보자 (강화 학습과 지도 학습은 사실 꽤 비슷하다).
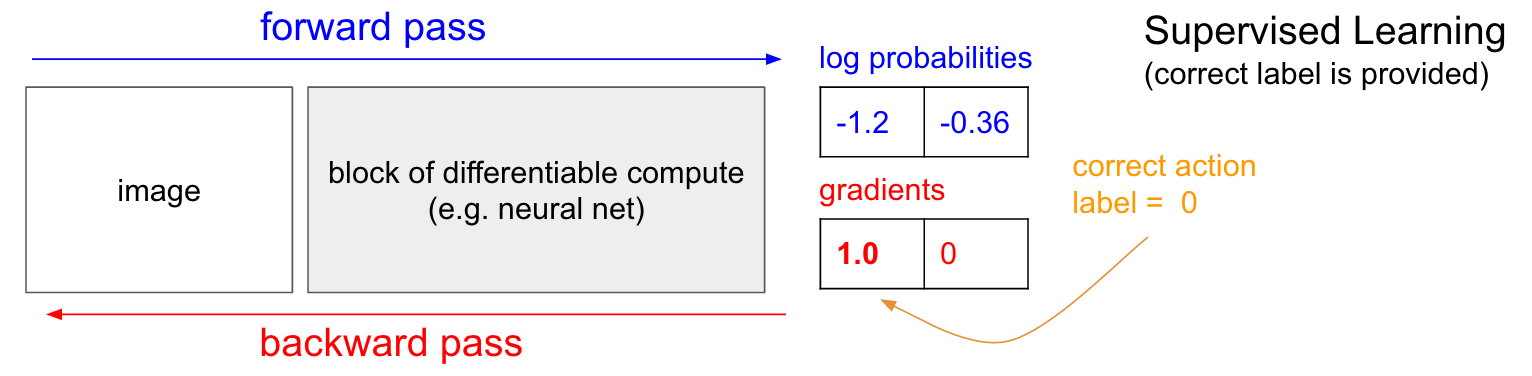
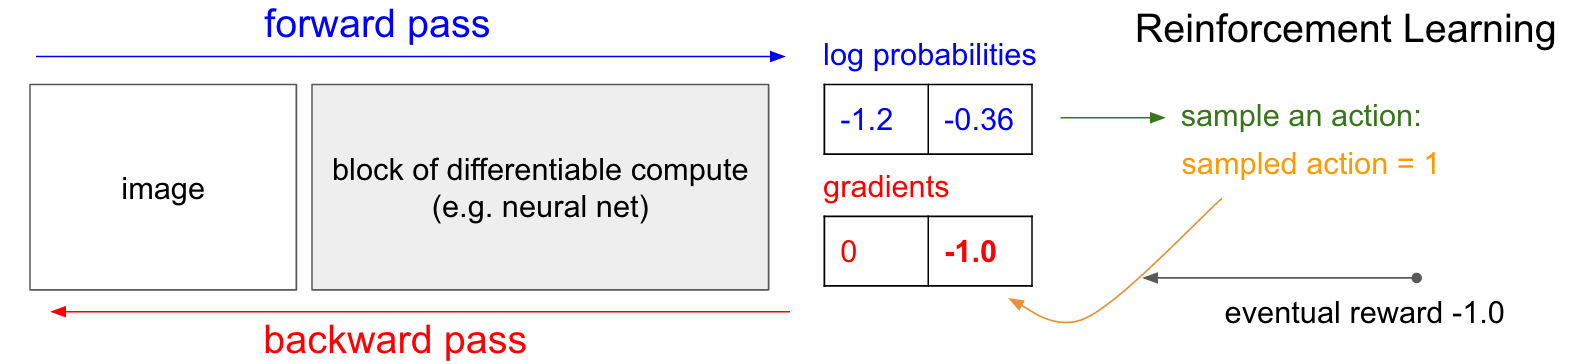
아래 그림은 지도 학습을 나타낸 그림이다. 입력 데이터로 이미지를 넣으면 forward pass를 거쳐서 결과로 각 라벨에 해당할 확률을 구할 수 있다 (여기서도 라벨이 UP/DOWN이라고 가정하자). [0, 1]의 확률이 아닌 log(확률)을 그림에 -1.2와 -0.36으로 표시했다 (30%와 70%에 해당한다). log(확률)로 쓴 이유는 이렇게 log()를 씌우는 것이 여러모로 계산하기에 편하기 때문이다. 로그 함수는 단조 증가 함수 (monotonic)라 log(확률)을 다루나 그냥 확률을 다루나 결과는 같다.
아무튼 forward pass를 통과해서 확률을 구했다고 하자. 그 결과가 UP이라면 UP 라벨의 그라디언트(기울기, 미분)를 1.0으로 놓고 backprop을 통해 각 가중치에 대한 그라디언트 벡터 ∇_W log p(y=UP∣x) 를 구한다. 이 그라디언트는 우리가 갖고있는 수백만개의 파라미터(가중치, 여기에선 W_1과 W_2)를 어떻게 바꿔야(얼만큼 증가 혹은 감소) 현재 입력을 넣었을 때 UP을 출력할 확률을 살짝 증가시킬 수 있는지를 알려준다. 예를 들어 어떤 가중치 값에 대한 그라디언트가 -2.1이라면 (그리고 학습률, Learning rate이 0.001이라면) 그 가중치 w는 w - (-2.1)*0.001 로 업데이트된다. 그리고 이 업데이트 덕분에 다음번에 비슷한 이미지가 들어왔을 때 올바른 판단을 내릴 확률이 살짝 증가한다.
정책 그라디언트 (Policy gradients)
그런데 강화학습이라면, 즉 우리가 정확한 라벨 값을 모른다면 어떻게 될까? 사실 구성은 비슷하다. 이번에도 정책망이 p(UP)=0.3, p(DOWN)=0.7의 값을 계산했다고 하자. 따라서 log(p(UP))과 log(p(DOWN))이 각각 -1.2, -0.36이 나왔다. 그리고 위에서 설명했듯이 이 30%와 70%의 확률 분포에서 샘플링을 하게 된다 (즉, 앞과 뒤가 각각 30%, 70%로 나오도록 설정된 동전을 튕겨서 결과를 사용한다). 샘플링의 결과가 DOWN이라고 가정하자. 그러면 이제 퐁의 막대기를 아래로 한번 움직이고 게임은 계속 진행된다. 자, 여기에서 지도학습과 차이가 나오게 된다. 이 시점에서 우리는 DOWN이 올바른 선택인지, 잘못된 선택인지 아직 알 수가 없다. 하지만 걱정할 필요 없다. 그냥 시간을 두고 기다리면 된다. 예를들어 퐁 게임이라면 게임이 끝날때까지 기다리면 된다. 게임이 승리로 끝나면 +1의 보상을, 패배로 끝나면 -1의 보상을 받게 된다. 그리고 이 보상 값을 DOWN의 그라디언트로 입력한다. 아래 그림을 보면 결과적으로 우리는 게임에서 패배했고 따라서 -1의 보상을 받는다 (eventual reward = -1.0). 이 값을 -log(p(DOWN))에 집어넣고 backpropatagion을 하면 결과적으로 아까의 상황에서 DOWN을 할 확률을 살짝 낮추게 업데이트된다.
이게 바로 강화학습의 원리다. 샘플링에 기반한 정책(stochastic policy)으로 행동을 결정하고, 게임에 승리할 경우 같은 선택을 할 확률을 증가시키고 패배했을 경우 감소시킨다. 보상은 꼭 -1과 1일 필요는 없다. 예를 들어 게임의 결과가 엄청 좋다면 +10을 줄 수도 있다. 파라미터 업데이트는 인공 신경망이 알아서 해줄 것이다.
학습 과정
학습 과정을 자세히 살펴보자. 우선 W1, W2는 임의의 값으로 초기화된다. 그리고 퐁 게임을 100번을 시키자 (이를 rollouts이라고 부른다). 게임 한판마다 200개의 프레임으로 이루어져있다고 가정하면 UP/DOWN의 선택을 총 20,000번 하게 된다. 그리고 2만번의 선택에 대해 우리는 승/패에 따른 보상을 입력하고, 결과적으로 2만번의 선택에 대해 가중치를 어떻게 업데이트해야할지를 (즉, 각 가중치에 대한 gradient를) 알고있다. 예를 들어 아직 학습이 많이 이루어지지 않아서 12번을 이기고 88번을 졌다고 하자. 그러면 승리한 12번 게임에서 이루어진 판단, 즉 12*200=2400번의 판단은 올바른 판단으로 보게 되고 따라서 앞으로 같은 판단을 내릴 확률을 조금씩 증가시킨다. 그리고 88*200=17,600의 판단을 잘못된 판단으로 보고 앞으로 같은 판단을 내릴 확률을 조금씩 감소시킨다. 이렇게 하면 정책망이 전보다 조금 더 올바른 판단을 내리게 된다.
이 과정을 계속 반복하면서 정책망을 학습시킨다.
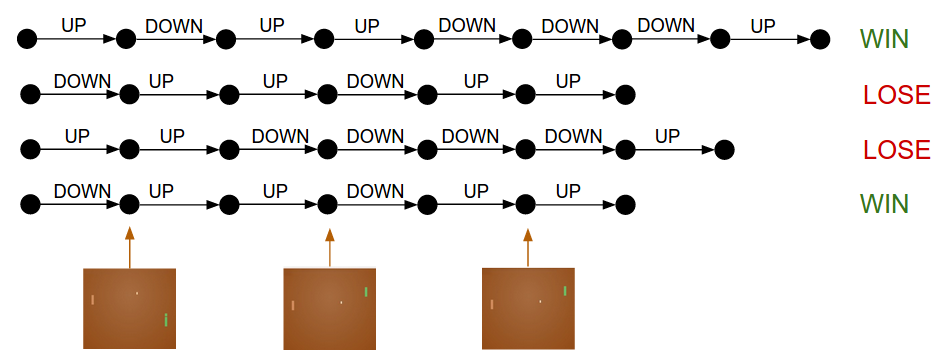
이 과정을 곰곰이 생각해보면 조금 불완전하다. 예를 들어 어떤 게임에서, 프레임 50에서 올바른 판단을 내렸지만 프레임 150에서 잘못된 판단을 내려서 최종적으로 게임에서 패배했다면, 프레임 50의 올바른 판단마저 부정적인 피드백을 받게 된다. 그렇지만 게임을 수백, 수천번 반복하면서 최종적으로는 올바른 판단은 +보상을, 잘못된 판단은 -보상을 받게 되는 것이다.
더 일반적인 advantage functions (보상 함수)
지금까지 설명한 과정에서는 게임에서 모든 행동을 그 게임의 승/패에 직접적으로 연관지어서 업데이트했다. 즉 게임에서 내린 200번의 판단과 그 게임의 승/패를 그대로 연결지었다. 실제로는 이것보다 조금 복잡한 과정이 있다. 상식적으로 생각해보면 모든 판단은 판단을 내린 직후에 가장 영향력이 크고, 시간이 지나면 점점 상관관계가 줄어든다. 즉, 게임이 200프레임에서 끝났다면 199, 198, 197 프레임의 판단은 승패에 큰 영향을 끼친 반면 1,2,3프레임의 판단은 사실 별 상관이 없을 것이다. 이를 고려해서 각 판단의 보상을 계산하는 경우가 많다. 즉 특정 시점 t에 내린 판단의 보상을
R_t=sum_{k=0}^{\inf} \gamma^{k} r_{t+k}, (역자 주: 기호로 나타내면)
Rt=∑_k=0 ^{∞} γ^k r_{t+k}
로 계산하는 것이다. 여기서 γ는 1보다 조금 작은 값(예:0.99)을 사용해 '망각'을 모델링 한다.
실제로 구현하는 경우에 또 하나 고려할 내용은 각 보상을 표준화(standardise)하는것이다. (역자 주: 이 내용은 생략합니다.)
정책 그라디언트 유도하기
(역자 주: 수식을 쓰기가 어렵기도하고 이 내용은 기본적인 소개보다 살짝 더 나간 부분이라 생략합니다.)
학습
이제 정책망에 대해 이해했으니 실제로 구현을 해보자. 퐁 게임을 130줄짜리 파이썬 코드로 짰다. 이 코드는 OpenAI Gym을 사용했다. 200개의 은닉 노드(hidden node)를 갖는 정책망을 짰고 RMSProp으로 학습을 시켰다. 내 구형 맥북으로 3일동안 학습을 시킨 결과 아타리에 내장된 인공지능보다 퐁을 더 잘 플레이하게 시작했다. 학습기간동안 대략 20만판의 퐁을 플레이했고 최종적으로 800번정도 파라미터를 업데이트했다. 전체 네트워크 구성을 더 정밀하게 짜고, GPU를 써서 더 오래 학습을 시킨다면 이것보다 좋은 결과를 볼 수 있을 것이다. 여기에서는 너무 열심히 최적화를 하진 않았다.
학습된 결과
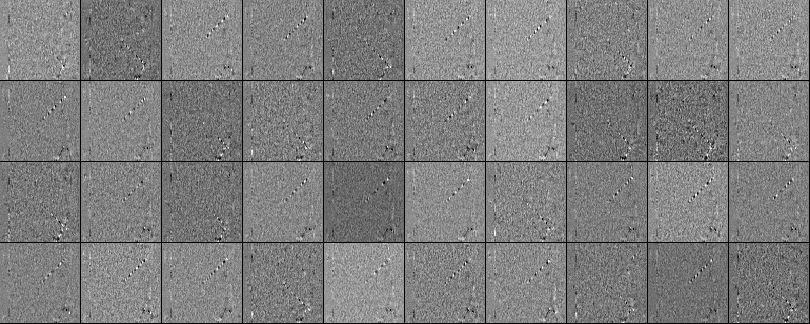
아래 그림은 학습이 끝난 가중치를 시각화한것이다. 위에서 이야기했듯이 (현재 프레임 - 과거 프레임)을 입력으로 사용했다. 아래 그림은 200개 뉴런중 40개를 골랐다. 하얀 픽셀이 양수, 검은 픽셀이 음수다. 이를 보면 몇몇 뉴런은 공의 궤적에 반응하도록 학습이 된것을 알 수 있다. 실제 게임에서 공은 딱 한군데에만 있을 수 있지만 뉴런 하나는 다양한 공의 위치에 반응할 수 있도록 (multi-task) 학습이 되었다. 데이터에 노이즈가 좀 있는데, L2 정규화를 했다면 아마 줄어들었을 것 같다.
학습 과정에서 일어나지 '않는' 것
지금까지, 픽셀 데이터를 보고 퐁 게임을 하는 정책망을 봤고 실제로 잘 작동한다. 이 방식은 guess-and-check, 즉 판단을 우선 내려보고 그 판단이 잘했는지/못했는지를 확인하는 과정의 반복이다. 세부적인 내용엔 차이가 있지만 이 방식이 현재 가장 잘 작동하는 방식이다. 한편으로 신기하기도 하지만 내막을 알고보면 다소 실망스럽기도 하다.
사람이 퐁 게임을 학습하는 과정을 생각해보자. 이 게임을 보여주고 게임 방식에 대해 이렇게 설명할 것이다. "너가 저 막대기를 올리거나 내릴 수 있고, 저 공을 쳐내서 상대방이 못받게 하면 너가 이기는거야." 그리고 게임을 시작할 것이다. 이 과정과 강화 학습엔 몇가지 차이가 있다.
- 우리는 언어를 통해 게임의 룰에 대해 알게되지만 강화학습은 그저 보상 함수가 정해져있고 이를 통해 스스로 게임을 파악해야한다. 만일 아무런 설명도 듣지 못하고 게임을 하게 된다면 강화학습과 같을수도 있다. 어쩌면 그런 상황이라면 강화학습이 사람보다 나을 수도 있다. 또, 만일 화면의 픽셀을 뒤죽박죽으로 섞어 놓아서 뭐가 뭔지 알 수 없게 해놓는다면 사람은 전혀 게임을 이해할 수 없겠지만 정책망 입장에선 데이터일뿐이므로 아무런 차이가 없다.
- 사람은 공이 튀기는 방식과 같은 물리적인 지식이나, 상대 인공지능도 이기려고 플레이 한다는 등의 사전 지식을 가지고 있다. 또 막대기를 조종하는 것도 쉽게 이해한다. 하지만 알고리즘은 전혀 그런 지식 없이 그냥 작동한다. 한편으로 생각하면 대단하기도 하고, 다르게 생각하면 그 과정을 정확히 이해할 수 없어서 답답하기도 하다.
- 정책망은 Brute force 방식이다. 즉, 올바른 판단이 무엇인지 모든 경우의수를 다 조사해보고 결과적으로 답을 알게된다. 하지만 사람은 모든 경우를 보지 않아도 추상화 과정을 통해 게임의 작동 방식을 이해한다. 예를 들어 사람은, 퐁 게임에서 인공지능의 움직임이 그렇게 빠르지 않으므로 공을 빠른 속도로 - 즉 직선 코스로 - 보내는 것이 승리하는 방법이라는걸 이해할 수 있다. 하지만 사람도 어떤 경우엔 이런 생각의 과정 없이 무의식적으로 일을 하기도 한다. 예를 들어 수동 기어 차량을 운전하는 법을 배운다면, 처음엔 기어 변속 과정을 머리로 생각하면서 실행하지만 어느 순간이 되면 거의 자동적으로, 무의식적으로 기어 변속을 한다.
- 정책망은 많은 보상을 받으면서 조금씩 학습하지만 사람은 훨씬 적은 데이터를 가지고도 어떻게 해야 많은 보상을 받는지 이해한다. 예를 들어 차를 운전하는 경우 꼭 벽에 차를 박아보지 않아도 그러면 안된다는걸 알고있다.
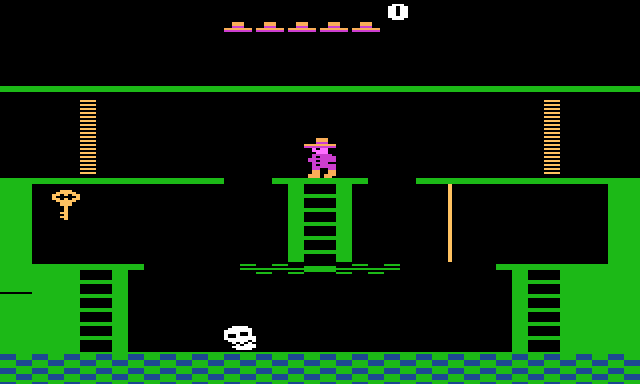
이제 원리를 이해했으니 정책망을 이용한 강화학습의 장단점을 알 수 있다. 아직 인공지능은 사람처럼 복잡하고 추상적인 개념까지 이해하면서 작업을 수행하지는 않는다. 하지만 언젠가는 그런날이 올 것이다.
미분 불가능한 연산을 포함한 인공 신경망
이제 마지막으로 한가지만 더 짚고 넘어가자. 이번에 다룰 이야기는 게임과 무관한 정책망 이야기다. 정책망을 이용하면 미분 불가능한 연산을 포함한 인공 신경망을 사용할 수 있다. 이 방법은 Recurrent Models of Visual Attention 논문에서 처음으로 소개됐다. 이 논문은 RNN으로 이미지에서 어디를 '보아야'(visual attention) 할 것인지를 결정한다. 문제는, 인공 신경망으로 어디를 볼지를 결정하는 과정이 미분 불가능한 연산이라는 점이다. 아래 그림을 보자.
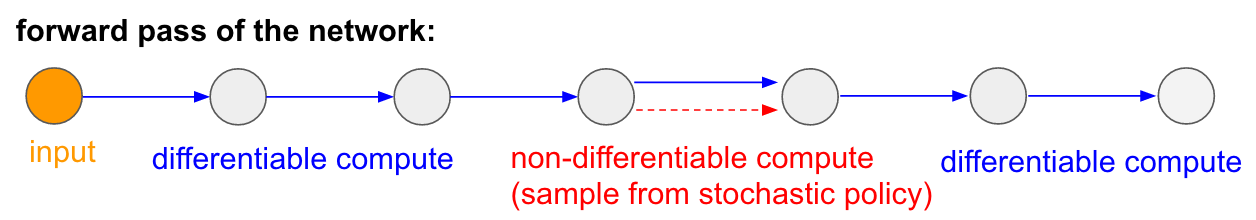
신경망에서 입력이 들어와서 어디를 볼지를 결정하는 과정을 간략히 나타낸 그림이다. 여기에서 대부분의 과정은 미분이 가능하지만 빨간색 화살표로 나타낸, 어디를 볼지를 '확률 분포에 의해 샘플링하는 과정'은 미분이 불가능하다. 따라서 backpropagation을 할 수가 없다.
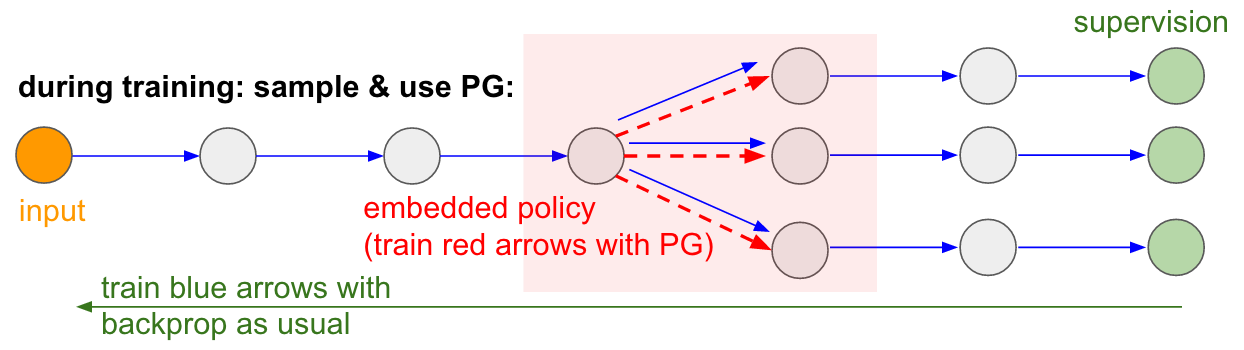
정책망을 이용하면 이 문제를 해결할 수 있다. 위의 그림에서 샘플링하는 경우의 수를 3가지로 보고 나타내면 아래 그림처럼 된다. 학습 과정에서, 여러번의 샘플링이 일어나게 되고 실제로 샘플링의 결과를 따라서 backpropagation을 하면 된다. 이 과정은 Gradient Estimation Using Stochastic Computation Graphs에 잘 나와있다.
학습 가능한 메모리 입/출력
위의 아이디어는 다른 연구에서도 볼 수 있다. 예를 들어 Neural Turing Machine은 '메모리 테입'이라 불리는 요소가 있고 여기에 데이터를 저장하고 불러온다. 뭔가를 저장하려면 m[i]=x 같은 연산을 수행해야하는데, 여기에서 i와 x는 RNN으로 구현된 컨트롤러 신경망이 결정한다. 이 경우도 샘플링이랑 비슷한데, 예를 들어 i가 아닌 위치를 사용할 경우에 발생하는 loss를 알려줄 방법이 마땅치 않다. 따라서 모든 메모리 셀 - 즉 모든 i - 에 대해 어떤 값을 할당할지를 전부 구해주고, i의 확률 분포를 전부 구해야 하는데 이렇게 하면 하나의 쓰기 연산을 위해 메모리 테입의 모든 위치 (모든 i)를 확인해야 한다. 따라서 연산이 엄청나게 비효율적이다.정책망을 쓰면 이를 효율적으로 해결할 수 있다 (RL-NTM 참조). 위의 여러 과정에서 샘플링을 했던 것 처럼, 메모리의 어디에 쓰기 연산을 수행할지 - 즉 변수 i - 를 샘플링하고 그 결과를 지켜보는 것이다. 실제로는, 수많은 메모리 위치 중에서 정확한 위치 i를 샘플링할 확률이 매우 낮기 때문에 이 방식은 경우의 수가 많은 상황에서는 적합하지 않다.
하지만 언젠가 아주 많은 연산과 데이터가 가능해지면 정책망을 통해 이 문제를 해결하게 될 수도 있다. 그리고 이 모든것이 더욱 더 발전하면 TCP/IP이나 컴파일러 등 복잡한 상황을 인공 신경망을 통해 해결하게 될 수도 있을 것이다.
결론
지금까지 정책망을 이용해 게임을 학습하는 방법을 알아봤다. 몇 가지 내용을 덧붙이겠다.
인공 지능의 발전에 대해
여기서는 모든 경우의 수를 다 탐색하는 (brute-force) 방법으로 알고리즘이 작동하는 것을 보았다. 또 사람은 이 경우에 인공지능과 전혀 다르게 접근한다는 사실도 언급했다. 이 과정에서 라벨을 명시하기에 매우 어려운, 따라서 지도 학습을 통해 풀기 어려운 내용이 많이 있기 때문에 비지도학습에 기반한 생성 모델(unsupervised generative model)이 많은 주목을 받고 있다.
복잡한 로보틱스 문제
이 알고리즘은 정말 많은 판단을 내려야 하는 복잡한 상황에 적용되기엔 연산량이 너무 많다. 예를 들어 자동으로 여러가지를 학습하는 로봇의 경우에 샘플링 기반의 학습은 적합하지가 않으므로 나온 방법이 deterministic policy gradients다. 그 외에도 구글의 로봇 팔이나 테슬라의 자동 운전 등의 다른 접근이 있다.그 외에도 경우의 수를 탐색하는 과정을 최적화 하는 다양한 시도가 있다. 예를 들어 알파고는 무작위 판단이 아니라 사람이 선택한 경우의 수를 기반으로 학습의 효율을 높였다. (역자 주: 이 문단 뒤쪽은 생략합니다)
현실에서 정책망을 사용하는 방법
마지막으로, 내 RNN 포스팅과 비슷하게 마무리를 짓고싶었다. 아무래도 내 RNN 포스팅을 읽은 사람들이 RNN을 이용하면 이 세상의 모든 sequence 데이터와 관련된 문제를 해결할 수 있다고 생각하는 것 같다. 하지만 실제로는 여러가지 까다로운 문제를 해결해야 RNN을 잘 활용할 수 있고, 굳이 RNN을 사용하지 않아도 될 수도 있다.정책망도 마찬가지다. 이 모든 과정은 완전 자동이 아니고, 데이터가 아주 많이 필요하고, 학습 과정이 엄청나게 오래 걸리고, 잘 작동하지 않는 경우엔 디버깅을 하기가 매우 까다롭다. 정책망을 적용하기 전에 먼저 Cross-entropy method를 베이스라인으로 구현해봐야한다. 그리고 나서도 정책망을 사용하려고 한다면 각종 책과 논문에 나온 나온 팁을 아주 자세히 보고, 아주 간단한 구성부터 시작을 해야한다. 그리고 일반적인 정책망보다는 약간 변형된 방법인 TRPO를 시도해보도록 해라. 대부분의 경우에 더 잘 작동한다고 알려져있다. TRPO의 핵심은 ...(역자 주: 제가 정확히 몰라서 이부분 생략합니다).
자, 이제 포스팅을 마친다. 이 포스팅으로 강화 학습에 대해 잘 이해했길 바란다. 강화 학습 연구에 더 본격적으로 참여하고 싶다면 OpenAI Gym을 활용하길 바란다.
Subscribe to:
Posts (Atom)