Tuesday, August 9, 2016

세상에 있는 (거의) 모든 머신러닝 문제 공략법

좋은 블로그 게시물이 나와서 번역합니다. 원문은 이곳을 참고하시기 바랍니다.
Karpathy의 글도 그랬지만 그림은 그대로 퍼오고, 글도 가급적 그대로 번역합니다. 교육 목적으로 활용해주시길 바랍니다.
제가 보충 설명을 하는 경우엔 괄호안에 (**요렇게) 적어놓았습니다.

세상에 있는 (거의) 모든 머신러닝 문제 공략법 (Approaching (Almost) Any Machine Learning Problem)

저자: Abshshek Thakur 
번역: 최근우

데이터 사이언티스트들은 하루종일 데이터를 다룹니다. 사람에 따라 다르겠지만 60-70%의 시간을 데이터를 전처리하고 원하는 형태로 변환하는데 사용한다는 사람도 있습니다. 그런 과정이 끝나고 나면 실제로 데이터에 머신러닝 알고리즘을 적용합니다. 이 글에서는 간단한 전처리 과정 및 머신러닝을 적용하는 과정을 자세히 다룹니다. 여기에서 소개하는 파이프라인은 제가 백개가 넘는 머신러닝 대회에 참가한 경험을 바탕으로 배운 내용입니다. 

파이썬을 사용해 설명드리겠습니다.

데이터

머신러닝을 활용하려면 데이터를 테이블의 형태로 변환해야합니다. 이 과정은 시간도 오래걸리고 힘든 과정입니다.

이 테이블의 각 행(row)은 각각의 데이터 샘플에 해당합니다. 보통 입력 데이터를 X, 레이블 (혹은 출력)을 y로 표현합니다. 레이블은 하나의 열(single column)일 수도 있고 여러 열로 이루어져 있을 수도 있습니다.

레이블의 종류

  • 단일 열, 이진수 (분류 문제. 레이블엔 두 개의 카테고리가 존재하고 모든 데이터 샘플은 반드시 둘 중 하나의 카테고리에만 해당하는 경우. 0과 1로 각각 다른 카테고리를 표현할 수 있으므로 이진값을 사용한다.)(**예: 텍스트를 보고 저자의 성별을 맞추는 경우)
  • 단일 열, 실수 (회귀 문제. 단일 열이므로 단 하나의 값만 예측하면 된다.)(**예: 텍스트를 보고 저자의 나이를 예측하는 경우)
  • 여러 열, 이진수 (분류 문제. 여러 카테고리가 존재하고 각 데이터는 하나의 카테고리에 해당한다.)(**예: 댓글을 보고 작성자가 응원하는 스포츠 팀을 맞추기, 이 경우에 열의 개수는 스포츠 팀의 개수와 같다.)
  • 여러 열, 실수 (회귀 문제이나 여러 값을 예측함.)(**예: 의료 검진 데이터를 보고 피검사자가 여러 종류의 암에 걸릴 확률을 예측. 이 경우 열의 개수는 암 종류의 개수와 같다.)
  • 다중 레이블 (분류 문제, 각 데이터 샘플이 여러개의 카테고리에 속할 수 있다.)(**예: 음악 신호를 보고 드럼, 기타, 보컬이 있는지 여부를 판단하는 경우. 열의 개수는 3개가 된다.)

평가 방법

어떤 경우든지간에 머신러닝 알고리즘의 평가는 필수입니다. 각 카테고리의 데이터 개수가 크게 차이나는 경우에 ROC AUC를 사용할 수도 있고, 다중 레이블 분류 문제는 카테고리 크로스 엔트로피나 다중레이블 로그 로스 등을 활용합니다. 
평가 방법은 상황에 따라 다르기 때문에 여기에선 자세히 다루지 않습니다.

라이브러리

필수적인 라이브러리를 몇 가지 소개합니다.
  • 데이터를 보고 간단한 연산을 수행: pandas
  • 각종 머신러닝 모델:  scikit-learn
  • 최강의 그라디언트 부스팅 라이브러리: xgboost
  • 뉴럴 네트워크: keras
  • 데이터 시각화: matplotlib
  • 실시간 모니터링: tqdm
아나콘다를 사용해 다양한 라이브러리를 쉽게 설치할 수 있습니다. 저는 사용하고있지 않지만 각자 판단하시길 바랍니다.

머신러닝 프레임워크


2015년부터 제가 개발중인 머신러닝 자동화 프레임워크의 그림입니다. 이 글에서도 그림과 같은 구조로 작업을 수행합니다.

가장 일반적으로 적용되는 단계를 진한 분홍색 화살표로 그렸습니다. 우선 앞에서 이야기한 전처리 과정을 거쳐 표 형태로 데이터를 정리하고나면 이 단계를 시작할 수 있습니다.

전처리


우선 우리에게 주어진 문제가 어떤 문제인지 파악해야합니다. 이진 분류(0 vs 1)인지, 여러 카테고리중 하나를 고르는 다범주 분류(multi-class classification)인지, 다중 레이블 분류문제인지 아니면 회귀 문제인지를 명확하게 결정해야합니다. 그리고 나면 우리가 가지고 있는 데이터를 학습 셋(training set)과 검증 셋(validation set)으로 나눕니다. 아래 그림을 참고하시길 바랍니다.


(**중요) 두 셋으로 나눌 때에는 반드시 레이블 정보를 사용해야합니다.  분류 문제의 경우 stratified splitting을 사용하시기 바랍니다. 파이썬에선 scikit-learn을 사용하면 됩니다. (**이렇게 하면 두 셋에서 레이블의 분포가 동일하게 유지됩니다.)


회귀 문제의 경우 그냥 간단하게 K-fold로 셋을 나눠주면 됩니다. 회귀에서도 분포를 유지하는 방법이 있긴 한데 독자여러분이 생각해보시길 바랍니다. (**아니 저기..)


이 코드에서는 검증 셋의 크기를 전체의 10%로 설정했습니다. 이 값은 가지고 있는 데이터의 크기에 따라 적절히 설정하면 됩니다.

이렇게 데이터를 나눈 뒤에는 두 셋을 동일하게 처리해야합니다. 그리고 절대 학습 셋과 검증 셋에 데이터가 겹치면 안됩니다. 그렇게 할 경우 마치 학습이 아주 잘 된 것 처럼 착각할 수 있습니다. 실제로는 엄청난 과적합(overfitting)이 일어나겠죠.

다음 단계는 데이터에 어떤 형태의 값이 있는지 알아내는 것입니다. 대략 숫자, 범주 정보, 그리고 문자열 데이터정도로 나눠서 생각할 수 있습니다. 카글의 타이타닉 데이터셋을 살펴볼까요?


여기에서는 survival이 레이블이 됩니다. 그리고 각 승객의 좌석 등급, 성별, 탑승한 항구는 범주화해서 생각할 수 있습니다. 나이, 형제자매의 수, 부모/자녀 등은 숫자 정보가 되구요. 마지막으로 이름은 문자열입니다. 이 작업 (**생존 여부를 예측하는 작업)에서는 크게 중요하지 않을 것 같군요.

우선 숫자를 봅시다. 이 값은 특별한 전처리 필요없이 바로 사용할 수 있습니다. 따라서 정규화(normalization) 및 머신러닝 기법을 바로 적용하면 됩니다.

범주 데이터는 두가지 방법으로 처리할 수 있습니다.
  • 카테고리를 라벨로 변환

  • 카테고리를 이진 변수 (one-hot-vector)(**하나의 성분만 1이고 나머지는 0인 벡터)로 변환

여기서 OneHotEncoder를 쓰기 전에 우선 LabelEncoder를 적용해야 하는 점을 주의하시기 바랍니다.

타이타닉 데이터셋의 문자열은 문자열 변수의 예로는 별로 좋지 않습니다. 일반적으로 문자열을 어떻게 다루는지 한번 알아보겠습니다.

우선 (**pandas를 쓸 경우) 아래 코드를 써서 데이터에 있는 모든 텍스트를 하나로 이어 붙일 수 있습니다.


그리고 여기에 CountVectorizer 또는 TfidfVectorizer를 사용합니다.


보통 TfidfVectorizer가 더 잘 작동합니다. (**당연히.. ) 대체로 아래처럼 셋팅하면 무난하게 사용 가능합니다.


만일 이 Vectorizer를 트레이닝 데이터에만 적용했다면, 나중에 사용할 수 있도록 하드디스크에 저장을 해놓아야합니다.


이제 Stacker 모듈을 봅시다. 여기에서는 다양한 특징값을 합칩니다.
일반적인 데이터는 np.hstack으로 벡터를 이어주면 됩니다.
만일 데이터가 sparse한 경우 (대부분의 값이 0인 경우) scipy.sparse를 사용합니다.


만일 PCA같은 과정이 포함되어있다면 sklearn.pipeline.FeatureUnion을 쓰면 됩니다.


자, 드디어 데이터 전처리가 끝났습니다. 
이제 머신러닝 알고리즘을 적용하면 됩니다.

머신러닝 적용

어떤 모델을 적용할까요? 위의 단계를 밟은 경우엔 트리 기반의 알고리즘만 가능합니다. 트리 기반의 모델은 여러가지 종류가 있습니다.

  • RandomForestClassifier
  • RandomForestRegressor
  • ExtraTreesClassifier
  • ExtraTreesRegressor
  • XGBClassifier
  • XGBRegressor
선형 모델을 사용하려면 위의 특징값을 Normalize하는 과정을 거쳐야합니다. sklearn의 Normalizer나 StandardScaler를 사용하면 됩니다. 단, 데이터가 dense한 경우에만 사용이 가능합니다. Sparse한 경우엔 결과가 좋지 않습니다. 

위의 트리 모델을 사용해서 그럭저럭 괜찮은 결과가 나왔다면 이제 모델을 자세하게 튜닝할 차례입니다.

다음 단계는 decomposition 입니다.


여기에선 LDA와 QDA는 생략합니다. 고차원 데이터의 경우 PCA(주성분분석)를 쓰면 차원을 효과적으로 줄일 수 있습니다. 이미지의 경우 10-15개의 성분을 사용해보고 차원을 늘려가며 성능을 비교해보십시오. 그 외엔 50-60개정도의 성분으로 시작해보십시오. 단, 값을 그대로 사용해도 괜찮은 상황이라면 굳이 차원을 줄일 필요는 없습니다.


텍스트의 경우는 sparse 행렬에 SVD를 적용합니다.

보통 120-200정도의 값을 사용합니다. 이보다 큰 값을 쓴다면 연산량에 유의하십시오.


이제 선형 모델도 사용할 수 있도록 특징값을 normalize하거나 re-scaling합니다. (**특징값의 범위를 조절) 그리고 나면 유용한 특징값을 고르는 Feature Selector 단계로 들어갑니다.


특징값을 선정하는 방법은 여러가지가 있습니다. Greedy 알고리즘을 쓸 경우엔, 우선 하나의 특징값을 골라서 모델을 돌리고 여기에 다른 특징값을 더하거나 빼면서 결과를 비교합니다. AUC로 모델을 평가하면서 특징값을 고르는 코드를 참고하십시오. 

아래의 코드는 RandomForest를 이용한 예제입니다. 이렇게 학습한 모델을 저장해놓고 나중에 사용할 수도 있습니다.


n_opimators 등의 하이퍼파라미터를 너무 크게 설정하면 과적합(overfitting)이 일어나니 주의하십시오.

혹은 xgboost를 사용할 수도 있습니다.


데이터가 sparse한 경우에도 RandomForestClassifier, RandomForestRegressor, xgboost 등을 사용 가능합니다.

그 외에도 chi-2로 특징값 선택이 가능합니다.


여기에선 k를 20으로 설정했는데, 이 값 역시 하이퍼파라미터이므로 최적화가 필요합니다.

지금까지 여러 모델을 소개했습니다. 데이터를 처리할 때 이렇게 학습한 모델을 꼭 저장해놓으십시오.

모델 선택 및 최적화

이제 모델을 선택하고 하이퍼파라미터를 최적화하는 일이 남았습니다.


널리 쓰이는 모델은 아래와 같습니다.
  • 분류
    • Random Forest
    • GBM
    • Logistic Regression
    • Naive Bayes
    • Support Vector Machines
    • k-Nearest neighbors

  • 회귀
    • Random Forest
    • GBM
    • Linear Regression
    • Ridge
    • Lasso
    • SVR

하이퍼 파라미터를 최적화하는 과정은 정해진 공식이 없습니다. 많은 사람들이 이와 관련해 질문을 합니다만 데이터와 모델에 따라 달라지기때문에 한마디로 말하기가 어렵습니다. 또, 몇 가지 팁이 있지만 경험이 많은 사람들은 이 비법을 숨기려고 하기도 합니다. 하지만 제가 알려드리겠습니다.

각 모델별로 어떤 하이퍼파라미터가 있는지 정리하면..


위의 값을 임의로 조합한 랜덤 서치를 추천합니다. 
제 생각일뿐이지만, 위의 값을 기반으로 찾아본다면 충분할겁니다.

정리

마지막으로 학습 과정을 정리해보면..


그리고 학습 과정에서 저장한 각종 변환(transform)을 다시 불러와서 validation/test set에 사용해야겠죠?


마무리

위의 과정을 잘 따라하면 대체로 아주 좋은 성능을 얻을 수 있을 것입니다. 물론, 잘 되지 않는 경우도 있겠죠. 그러면서 배우는 것이니 열심히 해보시길 바랍니다.

ISMIR 2016 - Day 0, Day 1, Day 2

지금 학회가 진행중입니다만 우선 2.5일치 정리합니다.

Day 0: Tutorial

T1은 재즈 역사 소개 / 재즈 데이터셋 및 발표자들이 개발한 툴을 소개했습니다. T1의 발표자인 Jakob Abeßer는 재즈 관련 연구를 많이 한 사람입니다. T4는 EEG에 대한 소개였는데 발표는 매우 지루했습니다. 발표자료를 github에 올렸다고 했는데 어딨을까요..;;

제가 제일 관심있는 내용은 Tutorial: Natural Language Processing for Music Information Retrieval입니다. 내용 자체는 매우 기본적인 NLP입니다. 그리고 링크를 들어가 보시면 음악 관련 데이터로 학습한 word2vec 모델을 공유하고있습니다. 

T2는 MIR에 관심있는분이나 연구/공부를 시작하는 분들을 위한 내용입니다.
T6 - Why Hip-Hop is interesting은 MIR에서 일반적으로 가정하는 음악 신호와 힙합이 어떤 차이를 갖고 있는지에 대한 내용입니다.

Day 1: Papers

12음계의 representation인 chromagram은 STFT/CQT에서 하모닉스를 단순히 더하는 방식으로 계산할 경우 신호의 하모닉스 성분때문에 많은 노이즈를 포함하게됩니다. 이를 deep neural network를 이용해 더 잘 계산해주겠다는 내용입니다.
Chromagram은 오디오 feature representation의 하나로 멜로디나 코드 추출 등에 사용할 수 있습니다. 딥러닝으로 Feature를 학습하는 방식이 정확히 어떤 쓰임새가 있을지 따지긴 어렵습니다만 연구 방식은 유효합니다.

한참 boundary detection논문을 내던 저자가 이번엔 다른 문제를 푸는 논문을 냈군요. 10k 트랙을 이용하는데, 레이블링 정보가 트랙 전체에 보컬이 있냐/없냐로만 되어있습니다. 이걸 컨브넷을 써서 학습시킨 결과를 다시 시간 프레임별로 적용하면 결과적으로 각 프레임에 보컬이 있냐 없냐의 문제 (제목의 Pinpoint이 의미하는 바가 이것이겠죠)를 풀 수 있다는 내용입니다.
즉, 곡 전체의 라벨로 학습시켜도 더 작은 단위의 판단을 잘 내릴 수 있게 된다는 내용이구요.

이 방식이 작동할 수 있는 이유를 대충 설명하자면 그냥 데이터가 많아서, 오차가 상쇄된다고 볼 수 있습니다. 다르게 보면 강화학습의 학습 과정과도 같은 셈입니다. 강화학습에서도 t0부터 t1사이에 일어난 모든 이벤트 중에 사실 중요한 이벤트는 아주 일부일 수 있습니다. 그렇지만 t0-t1사이의 모든 이벤트가 같은 레이블에 의해 reward나 penalty를 받게 되지요. 이 논문의 적용 방식도 같고, 다만 강화 학습에서는 그런 다양한 example이 시간축에 분포하는 반면 여기에서는 spectrogram의 하나의 axis일 뿐인 것이죠. 혹은 이미지 분류에서도 꼭 pixel별 라벨링이 되어있지 않아도 deconvolution을 해보면 어떤 위치에 객체가 있는지 대략 알아낼 수 있는것과 같습니다.

발표 마지막에 아주 재미있는 데모가 있었습니다. 결과적으로 이 컨브넷이 뭘 학습하냐?라는 것이었는데 아무 스펙트로그램에다가 선을 마구 그려서 컨브넷에 보여주니까 대각선 성분이 있으면 보컬이 있는것으로, 대각선이 없고 가로/세로선만 있으면 보컬이 없는 것으로 판단하더군요. 아..아이유의 삼단고음은 어떻게 될지 궁금하군요. 아무튼 그래서 스펙트로그램에 VOICE라고 그림을 확 그렸더니 (그림을 그린 부분이 높은 값을 갖게 되겠지요) V, O, C 처럼 대각선 성분이 있는 곳은 보컬이 있다고 판단을 하더군요.


Last.fm 로그를 수집합니다. 플레이로그와 함께 사용자의 나이/국가/성별을 모았구요.
그리고 사용자 모델링을 통해 3가지 feature를 제안했습니다. Exploratoryness, Mainstreamness, Genderness입니다. 앞의 2개는 EchoNest에서 artist profile에 있던것과 비슷한 내용이고, 이름도 직관적이죠. 마지막 featurer의 경우 저는 정확히 이게 어떤 작용을 할 것인지 잘 감은 안왔습니다만 Paul Lamere (Spotify)의 블로그 포스팅 Gender Specific Listening에서 소개한 것 등 남/녀의 취향 차이는 있겠죠.

이제 계산한 user feature와 demographics 정보를 이용해 추천을 해야하는데, 추가된 정보를 어떻게 user-item matrix에 집어넣어서 factorise를 해줄 수 있을 것이냐가 문제겠죠? 이 논문에서는
S. Rendle. Factorization machines. In IEEE 10th Inter- national Conference on Data Mining, pages 995–1000, Sydney, Australia, 2010. IEEE. 
의 방법을 사용했다고 합니다. 논문을 인용만 했는데 설명이 너무 안된것이 좀 아쉽군요. 안봤지만 아마도 여러 유사한 목적의 다른 논문처럼, factorise하기 위한 objective function에, 추가된 criteria에 맞춘 항을 더한뒤에 SGD로 최적화하는 전형적인 방식이 아닐까 생각합니다.

결과는 심플한데요, 논문의 그림 2를 보시면 이런저런 정보를 다 사용하면 Matrix factorisation의 RMSE가 제일 낮아진다 - 즉 retrospective evaluation의 결과로 제일 좋다 - 는 내용입니다.

뒷부분에 추가로 주말/주중이라는 컨텍스트 정보를 추가했는데 결과는 별로 성능이 좋아지지 않습니다. 제 의견은 사용자 모델링에서 사용자가 얼마나 컨텍스트에 민감한지 - 즉 user.contextualness 같은 내용을 더 모델링하지 않으면 컨텍스트 관련 추천은 늘 이런식이 아닐까 합니다. 저자랑도 비슷한 이야기를 했구요.


USC의 Julian McAuley가 발표한 Amazon review dataset이 있습니다. 여기에서 음악 관련 카테고리만 모아서 열심히 정리를 한 데이터셋인 MARD: Multimodal Album Reviews Dataset을 발표했습니다.

아마존 product ID와 Musicbrainz ID가 매칭이 안된다는 슬픈 이유로 (API에 항목은 있지만 값이 대부분 비어있습니다) Entity recognition을 써서 장르나 밴드 이름등을 뽑아는 등 각종 귀찮은 text preprocessing작업을 거쳐서 만든 데이터셋입니다. 

그리고 이 데이터셋을 이용해 장르 분류 작업을 간단히 보였구요. 

드럼 기초 테크닉인 strike(치는것), buzz roll, flam, drag 네가지를 구별하는 논문입니다. 


Day 2


MIREX라는 이벤트가 있습니다. ISMIR에서 하는 competition인데요, 음.......... 한마디로 이야기하면 이제 정말 문제가 많습니다. 작업 개수는 너무 많고, 관리에 어려움이 많고 비효율적이고 등등. 참다못한 Brian이 Kaggle for MIR을 만들어야한다! 라는 내용을 제안하는 발표였습니다.

각종 인프라를 위한 소프트웨어가 공개되어있고, 이래저래 가능한 시나리오입니다. 다만 중간중간에 돈이 들어가는 부분이 있고, 사람들의 참여가 많이 필요하겠죠. 시도가 잘 되길 빌고있습니다.

각종 스트리밍 서비스 - 정확히는 클라우드 뮤직 서비스, 즉 본인의 음악을 업로드해서 쓰는 iTunes Match, Amazon, Google Music - 에 대한 사용자 조사입니다.

중간에, 60%정도 되는, 많은 사람들이 돈을 지불하고 쓸 용의가 있다고 응답했다. 고 써있는데 저는 좀 회의적입니다. 설문조사에서 사람들이 솔직하게 답하지 않는 흔한 오류가 아닐까요? 그 사람들이 스스로 '돈을 낼 용의도 있는데?'라고 말하거나, 혹은 진심으로 그렇게 믿는다 하더라도 이렇게, 이렇게! 이렇게 좋은 뮤직 스트리밍 서비스가 많은데 지금도 공짜로 쓰는 사람들이 엄청나게 많은 마당에 무슨 의미가 있는걸지 잘 모르겠습니다. 행여나 그게 진심이라면 스트리밍 업체에서는 무료 사용자의 만족도를 일부러 낮춰서 결제를 유도해야하는걸까요?

슬라이드가 공개되어있는지 모르겠습니다만 사진 몇장 첨부합니다.


Michele가 퀸메리에 방문연구와서 연구한 내용이군요. NLP동네에 ANEW라는, Affective Norm for English Words, 즉 각종 감정에 관련된 단어를 Arousal-Valence-Dominance 총 3개의 축으로 된 3d 공간에 맵핑시켜놓은 데이터가 있습니다. 이 데이터가, 즉 벡터 맵핑이, 음악의 감정(mood/emotion) 관련된 태깅이나 분류 문제에 직접 사용하기엔 좀 맞지 않는 면이 있습니다. 저도 한번 테스트해봤다가 너무 맞지 않아서 관뒀는데, 이걸 이래저래하게 고쳐쓰자는 내용입니다.

몇 달동안 같은 연구실에 앞-옆자리에 앉아있던 친군데 이걸 연구했는줄을 오늘 알았습니다...


아주 재밌는 내용입니다. 전에 영문 블로그에 정리했던 ICML 2016: ML4MD 워크샵에서도 비슷한 논문이 있었습니다. 각종 아이템 (song, user, playlist,...)의 co-occurrence를 이용해 word2vec비슷한 embeddings을 학습시키고 그걸 이용해 추천이나 분석을 하는 내용이고 이 논문도 유사한 내용입니다.

이 연구의 특징은 Song, Session, User 이렇게 3가지 카테고리를 하나의 평면에 맵핑했다는 내용입니다. 여기서 Session이란 대략 플레이리스트 비슷한건데, 곡 하나가 끝나고 다음 곡 재생되는 시간 간격이 10분이 넘으면 별도의 session으로 보는걸로 정의했습니다.


그리고 위의 그림처럼 같은 network에 있으면 co-occurrence라고 보구요.

시각화를 위해서는 직접 2D로 embedding을 구했고, 추천에 이용한 벡터는 128차원입니다.

사용한 데이터는 타이완의 KK Music이라는 곳의 로그이고 2015년 상반기 6개월간의 데이터를 썼습니다.


평가는 precision-recall을 보았는데 가장 기본적인 MF보다 좋은 성능을 보입니다.


이 데이터가 좀 재밌습니다. 사용자 한명을 고정하고 그 사용자가 들은 음악을 2D 평면에 배치시킨 것입니다. 여기에 Clustering을 써서 사용자가 현재 듣는 세션이 어떤 '모드'의 세션인지 (즉 어떤 cluster에 해당하는지) identify한 뒤에 그에 맞는 추천을 해준다면 자연스럽게 personalised contextual recommendation이 될 것 같습니다.

제 연구 분야이기도 해서 저는 아주 맘에드는 내용이었습니다.

제가 포스터 세션이 조금 일찍 갔는데, 3저자인 지도교수가 1저자인 학생에게 아주 자세한 내용을 묻더군요. 음... 그러니까 와서 발표할때까지 지도교수는 이 논문이 어떤 내용인지 잘 몰랐다는 이야기가 되겠습니다. 거기에서라도 물어보고 관심 가지는게 어디냐 하는 생각을 했습니다.

그리고 이 세션이 끝나고 어쩌다가 아마존 뮤직(@씨애틀)에서 엔지니어로 일하고있는 사람과 이야기를 했는데, 자세한건 이야기할 수 없지만 이 논문과 아주, 아주 비슷한 알고리즘을 회사에서 사용중이라고 하더군요. 그 정도면 이미 말해선 안되는 내용을 말한 것 같습니다만... 


서울대 이교구교수님 연구실에서 나온 논문입니다. DNN을 스펙트로그램이 아닌 cepstrogram에 적용하는 내용입니다. 왜냐하면,
...because a cepstrogram is shown to be a more robust representation to capture the dymanics of the overall timbre than a spectrogram.
이라고 합니다. 제가 잘 모르는 내용이라 논문 본문을 인용했습니다.

...input representation을 잘 몰라서 뒷부분 내용을 리뷰하기가 어렵군요...

실험에서는 GTZAN dataset을 사용했습니다. 너무 오래된 데이터셋이라 좀 문제가 있는데, 
  1. Corey Kereliuk, Bob L. Sturm, and Jan Larsen. Deep learning and music adversaries. IEEE Transactions on Multimedia, 17(11):2059–2071, 2015. 
에서 제안한 splitting을 사용했습니다. 그리고 random splitting의 결과도 같이 본문에 포함했습니다. 


음악 추천 관련입니다. 사용자의 skip/playing을 기반으로 현재 곡에서 다음 곡으로 나아가야할 '방향' 벡터를 구해주고, 이에 맞춰 곡을 추천해주는 알고리즘입니다. '방향'을 구하는 알고리즘이 핵심이구요.

대략 설명하면, 사용자의 log를 보고 co-occurrence를 통해 곡과 곡의 관계를 graph로 정의합니다. 이 때 co-occurrence를 사용해 곡와 곡을 잇는 edge의 값 (=similarity)을 구해주구요. 그리고 그 graph를 그대로 사용하기엔 연산량이 많아서 ISOMAP으로 n-dimensional space로 맵핑해줍니다. 

그리고 그 space에서 각 곡의 '진행 방향', 즉 공간에서 곡과 다음 곡의 상대적인 위치를 이용해 현재 사용자의 '관성' (혹은 진행 방향/속도..)를 구하고, 이를 통해 다음 곡을 고릅니다. 만일 사용자가 스킵할경우엔 그 방향의 반대방향으로 진행하게 되구요.

상당히 잘 진행한 연구라고 생각합니다. 다만 평가하는 부분에서 와닿지 않는 부분이 많이 있었습니다. 실험 설계가 과연 제안한 알고리즘을 평가하기에 적합한지도 잘 모르겠구요. 하지만 dynamic listening 상황을 가정한 연구라 평가하기가 엄청나게 어려웠을걸 감안해야겠죠. 아주 아주 유효한 접근 방식이라고 생각합니다. 실험까지 잘되었으면 (그리고 지도교수의 도움으로 앞부분이 좀 더 멋지게 포장이 된다면) 진짜 훌륭한 논문이 되었을거란 생각이 들었습니다.

Saturday, June 25, 2016

논문 요약 - "Taste Space Versus the World: an Embedding Analysis of Listening Habits and Geography", Joshua Moore et al., ISMIR 2014

개요

  • 논문 다운로드는 여기를 누르세요.
  • 논문은 코넬 대학의 Joshua Moore가 쓴 논문입니다. 저자는 랩 동료인 Shuo Chen과 공저자로 MIR 관련 논문을 여러개 발표했습니다. Shuo Chen은 Markov Embedding을 이용한 플레이리스트 생성 논문을 발표한것이 좀 유명하구요, 지금은 졸업하고 MIR이 아닌 다른 분야에 있다고 하네요. 이 사람들 연구는 대부분 Embedding에 대한 내용입니다.
  • 이 논문은 ICML 2016: Machine learning for music discovery에서 발표한 "Embedding methods for visual analysis of music data"와 내용이 같습니다. 정확히 말하면 2014 ismir 논문을 다시 2페이지로 요약해서 icml에 냈다고 해야겠군요. Invited talk이기도 해서 별 문제될거야 없지만 저는 왜 2년전 연구가 조금의 추가 내용도 없이 이렇게 나올 수 있었는지 불만입니다.  게다가 성의도 없고 레퍼런스는 dataset 인용 하나와 본인논문 4개;; 음;; 뭐 ...
  • 그렇지만 ismir 논문은 괜찮은것같고, embedding을 어떻게 정의하고 사용하는지 사례를 알고싶어서 자세히 읽어보기로 했습니다.

Embeddings

임베딩, 보통 word embeddings가 많이 쓰이죠. 임베딩이란..
  • 고차원의 데이터를 그보다 낮은 차원으로 맵핑하되,
    • 즉 N-dim vector → M-dim vector로 바꾼다고 하면 N>M이고, 대체로 N>>M이겠죠. 
  • 맵핑한 결과(embeddings)가, 낮은 차원의 공간 각 데이터의 '관계'가 성립하도록 해주는 작업입니다.
    • N차원 공간의 특성이 무엇이었든지간에, M차원으로 옮겨줬을 때 각 데이터 벡터 - 즉 임베딩 - 사이가 의미가 있길 바라는거죠. 예를 들면,
      • word2vec:
        •  5만개의 단어가 있다 치죠. 얘네들은 5만차원의 one-hot-vector로 나타낼 수 있습니다. 그리고 5만차원의 벡터를 100차원 공간에 맵핑시키는데, 맵핑한 결과가
          • w2v(남자) - w2v(여자) == w2v(왕) - w2v(여왕)
          • w2v(한국) - w2v(서울) == w2v(프랑스) - w2v(파리)
        • 와 같은 등식이 (근사적으로) 성립하도록 만들어주는 것이지요.
      • t-SNE:

          • 고차원의 데이터를 2차원으로 줄여서 시각화하는 방법입니다. 유사한 데이터가 비슷한 곳에 모이게 되죠. 예를 들어 MNIST의 숫자 필기의 픽셀 값을 (28*28=784차원 데이터) t-SNE를 써서 2차원으로 표현해주면 아래와 같이 됩니다.

Embeddings: HOW?

  • 여러가지 방법이 있죠. word2vec은 단어의 문맥을 보고 판단합니다. 즉 주변에 있는 단어의 값을 활용합니다. 따라서 word sequences - 충분한 양의 글 - 만 있으면 됩니다.
  • t-SNE는, 그 이름을 보면
    • t-distributed Stochastic Neighbor Embedding 입니다. 즉,
    • t-SNE는 비슷한 값들이 비슷한 위치에 - 즉 neighbor가 되도록 만드는 것이 목적입니다. 역시 원본 데이터 - 고차원 벡터 - 만 가지고 판단합니다. 
  • 그런데 이 외에도 다양한 경우가 있습니다.
    • 예를 들어 Joshua의 논문은 Million Song Tweets Dataset을 사용했습니다. 이 데이터셋은 트윗에서 긁어모은 데이터인데, 수많은 (음악(곡,아티스트,앨범), 위치(도시)) 의 tuple로 이루어져있습니다.
    • 그리고 이 논문의 목적은 이 데이터를 이용해서
      • embedding 1, X( ): city ti embedding space, c → X(c)
      • embedding 2, Y( ): artist to embedding space, a → Y(a)
    • 를 만들어주는데, 이 X( )와 Y( )의 차원이 같게 설정해주는거죠. 그리고나서 Y(a), artist와 X(c), 도시(city)의 관계를 찾아보자는 내용입니다. 
    • tuple형태의 데이터가 있다면 다른 상황에도 적용이 가능하겠죠. 

제안한 알고리즘

자세한 내용을 보면, 우선 여기에서는 트위터에서 곡 정보를 빼고 아티스트 정보만 모았습니다. 그리고 위치 정보는 '도시'만 남겼구요. a를 아티스트,  c를 도시라고 하면 임베딩을 학습한 결과는..
    • P(a|c), 즉 각 도시에 대해 아티스트 a를 들을 확률과
    • euclidean distance(X(c) - Y(a))
  • 이 둘이 비례하는 결과가 나오면 됩니다.
섹션 3의 식을 보면 p_a가 추가되어있는데 이건 아티스트의 인기(popularity)를 감안해주기 위한 bias입니다. 이를 이용해 P(a|c)를 정리했습니다. 바로 아래와 같죠. (이 논문엔 왜 식에 번호를 안붙였을까요; 우린 그냥 (1)이라고 합시다.)
 (1)

이제 이 확률 식에 맞추어 X(), Y()를 찾으면 됩니다!

찾는 방법은 Maximum (log) Likelihood로 정리하고, 이를 SGD로 푸는거군요. 즉, 가지고 있는 데이터에 근거해 (1)을 극대화해주는 X, Y, p_a를 구하면 됩니다. 다시말해,
 (2)
가 됩니다.

이제 SGD문제가 되고, 열심히 돌려주면 됩니다. 저자가 언급하기를 여기서 연산량의 문제가 되는 부분이 (1)의 분모로 들어가있던 partition function Z()입니다. [6]의 방법으로 근사했다는데 역시 같은 저자의 2013년 ismir논문이네요.

그 외

뒷부분은 실제로 실험을 돌렸더니 이러저러하더라 라는 내용이라 생략하겠습니다.

정리

결과적으로 우리가 원하는 의미에 따라 식 (1)을 정의해주고 이를 식(2)처럼 풀면 된다는 막상 간단한 내용이네요.
[6]의 논문은 tuple이 아니라 triplets에 대한 내용입니다만 역시 유사한 방법으로 문제를 풀어줍니다. 수식 전개가 비교적 더 자세히 나와있습니다.
ISMIR논문이 레퍼런스 섹션 별도 할당 없이 전체 6페이지이던 시절이라 레퍼런스가 좀 부실하지만, 원하는 상황에 어떻게 Embedding을 만들어 줄 수 있는지 간단하게 이해가 되었네요.

최적화는 늘 그럿듯 SGD가 두루두루 쓰일테고, 식 (1)을 얼마나 실제 데이터에 맞추어 잘 세워주느냐가 중요한 내용일 듯 합니다.


Saturday, June 4, 2016

강화학습 튜토리알 - 인공 신경망으로 '퐁' 게임을 학습시키자 (Andrej Karpathy 포스트 번역)

강화학습에 관심만 많던 차에 Andrej Karpathy가 훌륭한 튜토리알을 썼네요. 꼼꼼히 읽어볼 겸 번역합니다. 원문은 http://karpathy.github.io/2016/05/31/rl/ 입니다.

심층 강화학습

최근에 강화학습이 큰 인기를 끌고있다. 최근 이슈가 된 연구는 게임 화면을 보여주는것 만으로 아타리 게임을 조작하도록 학습하는 것, 이세돌과 알파고의 바둑 대결, 로봇이 걷고 뛰는 과정을 학습하는 것 등이 있다.  나도 작년부터 강화학습에 관심을 갖기 시작했고 Richard Sutton의 책, David Silver의 강의, John Schulmann의 강의를 보았고 Javascript로 강화학습 라이브러리를 짜기도 했다. 여름엔 딥마인드의 DeepRL그룹에서 인턴으로 일했고 최근에 OpenAI에서 발표한 강화학습 벤치마크 도구 OpenAI Gym의 개발에도 살짝 발을 담궜다.


강화 학습에 대해 이야기할 내용이 많이 있다. 우선, 개인적으로 현재 인공지능 발전을 위해 해결해야할 문제를 아래 네 가지 정도로 보고있다.

  1. 연산량 (무어의 법칙 등)
  2. 데이타 (이미지넷처럼 잘 만들어진 데이타셋)
  3. 알고리즘 (backprop, 컨볼루션뉴럴넷, LSTM 등)
  4. 환경 (리눅스, git, AWS, TensorFlow 등 각종 소프트웨어)
컴퓨터 비전분야와 마찬가지로, 강화학습 역시 엄청나게 새로운 아이디어가 나타나서 이렇게 뜨고 있는것이 아니다. 2012년에 등장해 컨브넷의 시대를 연 알렉스넷은 대략 90년대의 컨브넷의 규모를 키운 버전이다. 마찬가지로 2013년에 소개된, 아타리 게임을 학습하는 Deep Q Learning은 함수 근사 (function approximator)로 컨브넷을 사용한 것을 제외하면 매우 일반적인 알고리즘이다 (함수 근사를 이용한 Q 학습은 1998의 Sutton 책에 소개된 내용이다). 알파고는 정책 그라디언트 (policy gradient)와 몬테-카를로 트리 탐색 (MCTS, Monte Carlo Tree Search)를 사용했는데 이 역시 널리 알려진 방법이다. 물론 이런 기본적인 방식이 이론상이 아니라 실제로 실험에서 잘 작동하게 하려면 각종 복잡한 기술을 동원해야한다. 하지만, 최근에 소개된 각종 연구의 일등공신은 알고리즘이 아니라 연산/데이터/환경이다. 

다시 강화학습으로 돌아오자. 나는 정말 신기한 기술이 실제로는 엄청나게 단순한 원리로 작동하는걸 깨닫고 나면 블로그에 글을 쓰고싶어진다. 이 글의 경우엔 단 하나의 핵심 알고리즘과 게임 화면 정보를 주면 컴퓨터가 사람 수준으로 아타리 게임을 플레이할 수 있다는 놀라운 사실을 받아들이지 못하는 사람을 보며 글을 적어야겠다는 생각을 했다. 사실은 나도 선뜻 받아들이지 못했었다. 돌이켜보면 모든 것들이 다 그렇지만, 이 알고리즘도 정말 어이없을만큼 간단하다. 우선 여기서 독자들에게 정책 그라디언트 (Policy Gradient, PG)를 소개해주려고 한다.
PG는 현재 강화 학습에서 가장 흔하게 쓰이는 기법이다. 왜 Deep Q Network를 다루지 않느냐고? DQN이 강화 학습에서 제일 좋은 방법 아니냐고? 2013년에 처음 아타리 게임 논문에서 소개되었을 때엔 DQN이 최강의 알고리즘이라는 의견이 있었지만 현재 시점에서 보면 DQN보다 PG가 더 좋다. 실제로 대부분의 사람들이 PG를 선호한다. 심지어 DQN논문의 저자들도 잘 튜닝을 하면 PG가 DQN보다 더 좋다는 논문을 발표했다. 자 이제, 우리는 컴퓨터가 아타리 게임 중 Pong을 플레이할 수 있도록 PG를 이용해 학습시킬 계획이고 당연히 컴퓨터는 픽셀 정보만 사용한다. 이 예제는 Numpy만 이용해 130줄의 파이썬 코드로 되어있다.

화면을 보고 퐁을 배우자! (Pong from pixels)

퐁은 간단한 강화 학습용 예제로 아주 적절한 게임이다. 아타리2600버전을 보면 위/아래 화살표로 막대기를 조절해 공을 받아낸다. 만일 공을 받아치지 못하면 패배한다는 규칙이다. 데이터 관점에서 보면 이렇다. 각 화면은 210x160 픽셀이고 RGB채널을 고려하면 210x160x3바이트의 데이터가 된다. 연속된 화면을 받게 되므로 실제 데이터는 210x160x3크기의 성분으로 이루어진 어레이가 된다. 이 데이터를 받고, 막대기를 위로 올릴지 혹은 아래로 내릴지를 판단하면 된다. 이렇게 내린 모든 판단은 나중에 피드백을 받게 된다. 만일 상대가 공을 받는데 실패했다면 +1의 보상을, 내가 공을 못받았다면 -1을, 둘 다 아니면 0의 보상을 받는다. 당연히 +1의 보상을 받것이 우리의 목표다.

중요한건, 실제로 퐁을 어떻게 플레이하느냐가 문제가 아니라는 것이다. 복잡한 데이터가 들어오고, 우리가 어떤 판단을 내려야 보상이 극대화가 되는지를 자동으로 학습하도록 한다는 그 설정이 중요하다. 퐁은 그냥 예제로 선정된 게임일 뿐이다. 

정책망 (Policy Network)

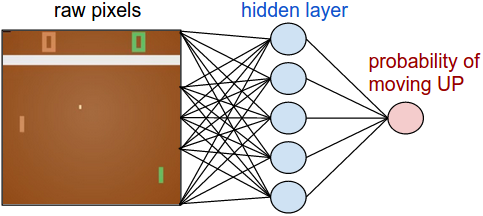
우선 정책망을 우리의 선수(player) 혹은 요원 (agent)라고 정의하자. 정책망은 현재 게임의 상태가 어떤지를 입력으로 받고 이를 토대로 우리가 어떤 행동을 취해야하는지 (UP or DOWN; 막대기를 위로 올릴지 아래로 내릴지)를 판단한다. 데이터(화면)과 레이블(행동) 사이를 인공 신경망으로 이어주자. 여기에서는 층이 2개인 인공 신경망을 사용할 것이다. 여기에서 입력은 100,800 (210 * 160 * 3)개의 노드가 되고 최종적으로 UP이 될 확률이 출력이 될 것이다. 이 구성은 흔하게 쓰이는 Stochastic 정책이다. (어떤 선택을 내릴지의 확률을 구하는 경우 여기에 해당한다.) 학습 과정에서 우리는 이 확률 분포를 토대로 어떤 행동을 취할 것인지를 샘플링을 한다. 예를 들어 70%의 확률로 UP인 상황이라면 p(UP):p(DOWN) = 7:3인 동전을 튀겨서 나온 결과를 사용한다. 이렇게 하는 이유는 뒤에서 설명하겠다.


이 과정을 파이썬 코드로 쓰면 아래와 같다.

h = np.dot(W1, x) # compute hidden layer neuron activations
h[h<0] = 0 # ReLU nonlinearity: threshold at zero
logp = np.dot(W2, h) # compute log probability of going up

p = 1.0 / (1.0 + np.exp(-logp)) # sigmoid function (gives probability of going up)

W1, W2는 임의의 값으로 초기화된다. Bias는 생략하자. 마지막 줄을 보면 sigmoid함수를 사용해서 결과 값이 [0, 1] 사이의 확률이 되도록 하는 것을 알 수 있다. 정리하면, 인공 신경망이 화면을 보고 게임 상황을 이해한 뒤 UP/DOWN중 무엇을 해야 하는지를 결정해주게 될 것이다. 학습 되기 전이라면 임의로 설정된 W1, W2가 어떤 판단이든 내릴 것이다. 자, 이제 학습을 통해 W1, W2가 의미있는 값이 되도록 - 즉 퐁을 플레이할 수 있도록 만들어주자!

팁: 전처리를 해야한다. 원래대로라면 적어도 2개 이상의 프레임 정보를 받아서 공의 움직임을 파악하게 해야한다. 여기에서는 연산량을 더 줄이기 위해 전 프레임과 다음 프레임의 차이를 입력으로 넣어주자.

가능한가?

우선 강화 학습이 얼마나 까다로운 문제인지를 파악해보자. 입력 값으로 100,800개의 값을 받고 그 결과로 UP/DOWN을 결정해야 한다 (W1, W2의 크기는 대략 수백만개 이상일것이다). 어떤 시점(n)에, 판단이 UP으로 결정이 되었다고 가정해보자. 그리고 별 일이 일어나지 않아서 보상으로 0을 받고 다음 시점(n+1)이 되면 또 100,800개의 값이 (다음 화면이) 입력으로 들어온다. 또 이걸 하고, 이걸 수백번 반복하고 나면 어느순간 드디어 0이 아닌 보상을 받게 될 때가 올 것이다. 예를 들어 우리가 게임을 이겼고 (만세!) 그래서 +1의 보상을 받았다고 하자. 그런데, 그동안 반복한 수백번의 행동중에 어떤 행동이 승리에 결정적인 요인이 되었는지 판단할 수 있나? 마지막에 움직인건가? 아니면 76프레임 전에? 아니면 10프레임과 90프레임때? 그리고 수백만개의 가중치를 어떻게 바꿔야 좋을지 어떻게 구할 수 있나? 
이 문제를 credit assignment problem이라고 부른다. 즉, 어떻게 공을 치하해야할지를 할당하는 문제이다. 진짜 결정적인 요인으로 우리가 공을 받아내기 어려운 곳으로 보낸 행동이 있을 것이다. 그리고 그 이후의 움직임은 승리에 전혀 도움이 되지 않는 행동이었다. 이걸 판단하는 문제는 언뜻 생각해도 쉽지 않다.

지도 학습 (Supervised learning)

PG를 하기 전에 잠시 지도 학습에 대해 알아보자 (강화 학습과 지도 학습은 사실 꽤 비슷하다). 
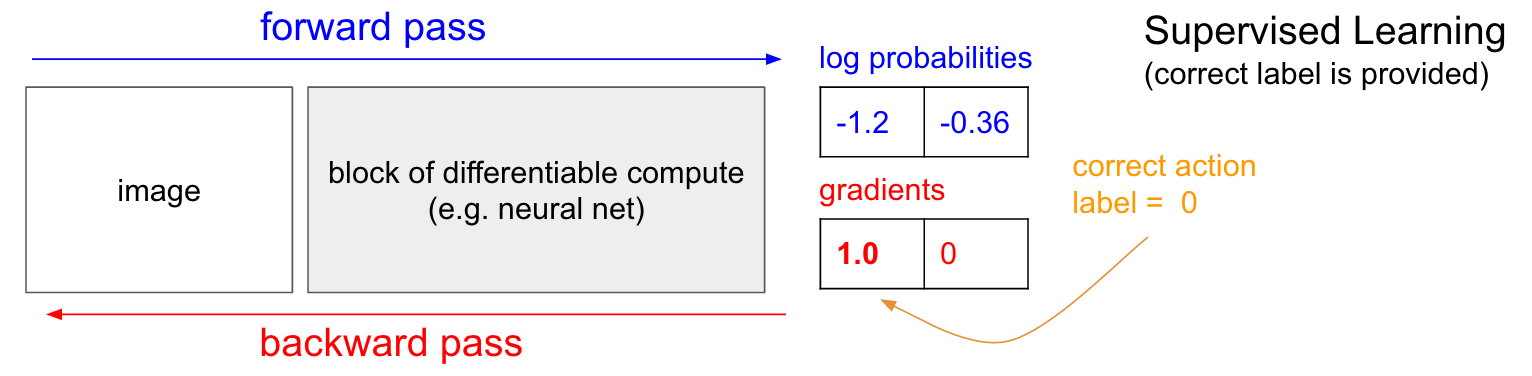
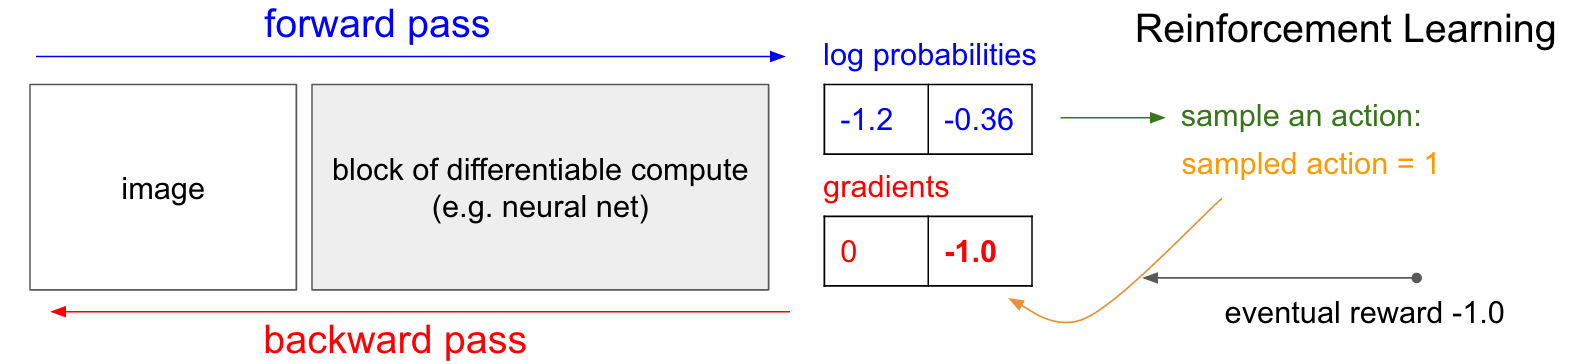
아래 그림은 지도 학습을 나타낸 그림이다. 입력 데이터로 이미지를 넣으면 forward pass를 거쳐서 결과로 각 라벨에 해당할 확률을 구할 수 있다 (여기서도 라벨이 UP/DOWN이라고 가정하자). [0, 1]의 확률이 아닌 log(확률)을 그림에 -1.2와 -0.36으로 표시했다 (30%와 70%에 해당한다).  log(확률)로 쓴 이유는 이렇게 log()를 씌우는 것이 여러모로 계산하기에 편하기 때문이다. 로그 함수는 단조 증가 함수 (monotonic)라 log(확률)을 다루나 그냥 확률을 다루나 결과는 같다.
아무튼 forward pass를 통과해서 확률을 구했다고 하자. 그 결과가 UP이라면 UP 라벨의 그라디언트(기울기, 미분)를 1.0으로 놓고 backprop을 통해 각 가중치에 대한 그라디언트 벡터 ∇_W log p(y=UP∣x) 를 구한다. 이 그라디언트는 우리가 갖고있는 수백만개의 파라미터(가중치, 여기에선 W_1과 W_2)를 어떻게 바꿔야(얼만큼 증가 혹은 감소) 현재 입력을 넣었을 때 UP을 출력할 확률을 살짝 증가시킬 수 있는지를 알려준다. 예를 들어 어떤 가중치 값에 대한 그라디언트가 -2.1이라면 (그리고 학습률, Learning rate이 0.001이라면) 그 가중치 w는 w - (-2.1)*0.001 로 업데이트된다. 그리고 이 업데이트 덕분에 다음번에 비슷한 이미지가 들어왔을 때 올바른 판단을 내릴 확률이 살짝 증가한다.


정책 그라디언트 (Policy gradients)

그런데 강화학습이라면, 즉 우리가 정확한 라벨 값을 모른다면 어떻게 될까? 사실 구성은 비슷하다. 이번에도 정책망이 p(UP)=0.3, p(DOWN)=0.7의 값을 계산했다고 하자. 따라서 log(p(UP))과 log(p(DOWN))이 각각 -1.2, -0.36이 나왔다. 그리고 위에서 설명했듯이 이 30%와 70%의 확률 분포에서 샘플링을 하게 된다 (즉, 앞과 뒤가 각각 30%, 70%로 나오도록 설정된 동전을 튕겨서 결과를 사용한다). 샘플링의 결과가 DOWN이라고 가정하자. 그러면 이제 퐁의 막대기를 아래로 한번 움직이고 게임은 계속 진행된다. 자, 여기에서 지도학습과 차이가 나오게 된다. 이 시점에서 우리는 DOWN이 올바른 선택인지, 잘못된 선택인지 아직 알 수가 없다. 하지만 걱정할 필요 없다. 그냥 시간을 두고 기다리면 된다. 예를들어 퐁 게임이라면 게임이 끝날때까지 기다리면 된다. 게임이 승리로 끝나면 +1의 보상을, 패배로 끝나면 -1의 보상을 받게 된다. 그리고 이 보상 값을 DOWN의 그라디언트로 입력한다. 아래 그림을 보면 결과적으로 우리는 게임에서 패배했고 따라서 -1의 보상을 받는다 (eventual reward = -1.0). 이 값을 -log(p(DOWN))에 집어넣고 backpropatagion을 하면 결과적으로 아까의 상황에서 DOWN을 할 확률을 살짝 낮추게 업데이트된다.


이게 바로 강화학습의 원리다. 샘플링에 기반한 정책(stochastic policy)으로 행동을 결정하고, 게임에 승리할 경우 같은 선택을 할 확률을 증가시키고 패배했을 경우 감소시킨다. 보상은 꼭 -1과 1일 필요는 없다. 예를 들어 게임의 결과가 엄청 좋다면 +10을 줄 수도 있다. 파라미터 업데이트는 인공 신경망이 알아서 해줄 것이다.

학습 과정

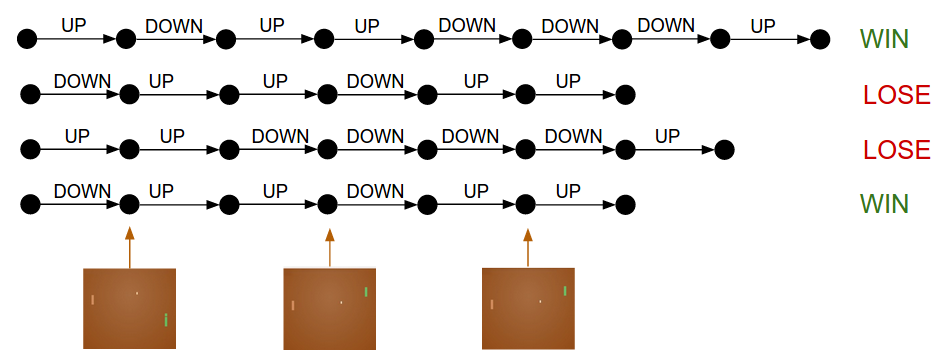
학습 과정을 자세히 살펴보자. 우선 W1, W2는 임의의 값으로 초기화된다. 그리고 퐁 게임을 100번을 시키자 (이를 rollouts이라고 부른다). 게임 한판마다 200개의 프레임으로 이루어져있다고 가정하면 UP/DOWN의 선택을 총 20,000번 하게 된다. 그리고 2만번의 선택에 대해 우리는 승/패에 따른 보상을 입력하고, 결과적으로 2만번의 선택에 대해 가중치를 어떻게 업데이트해야할지를 (즉, 각 가중치에 대한 gradient를) 알고있다. 예를 들어 아직 학습이 많이 이루어지지 않아서 12번을 이기고 88번을 졌다고 하자. 그러면 승리한 12번 게임에서 이루어진 판단, 즉 12*200=2400번의 판단은 올바른 판단으로 보게 되고 따라서 앞으로 같은 판단을 내릴 확률을 조금씩 증가시킨다. 그리고 88*200=17,600의 판단을 잘못된 판단으로 보고 앞으로 같은 판단을 내릴 확률을 조금씩 감소시킨다. 이렇게 하면 정책망이 전보다 조금 더 올바른 판단을 내리게 된다.
이 과정을 계속 반복하면서 정책망을 학습시킨다.


이 과정을 곰곰이 생각해보면 조금 불완전하다. 예를 들어 어떤 게임에서, 프레임 50에서 올바른 판단을 내렸지만 프레임 150에서 잘못된 판단을 내려서 최종적으로 게임에서 패배했다면, 프레임 50의 올바른 판단마저 부정적인 피드백을 받게 된다. 그렇지만 게임을 수백, 수천번 반복하면서 최종적으로는 올바른 판단은 +보상을, 잘못된 판단은 -보상을 받게 되는 것이다.

더 일반적인 advantage functions (보상 함수)

지금까지 설명한 과정에서는 게임에서 모든 행동을 그 게임의 승/패에 직접적으로 연관지어서 업데이트했다. 즉 게임에서 내린 200번의 판단과 그 게임의 승/패를 그대로 연결지었다. 실제로는 이것보다 조금 복잡한 과정이 있다. 상식적으로 생각해보면 모든 판단은 판단을 내린 직후에 가장 영향력이 크고, 시간이 지나면 점점 상관관계가 줄어든다. 즉, 게임이 200프레임에서 끝났다면 199, 198, 197 프레임의 판단은 승패에 큰 영향을 끼친 반면 1,2,3프레임의 판단은 사실 별 상관이 없을 것이다. 이를 고려해서 각 판단의 보상을 계산하는 경우가 많다. 즉 특정 시점 t에 내린 판단의 보상을 
R_t=sum_{k=0}^{\inf} \gamma^{k} r_{t+k}, (역자 주: 기호로 나타내면)
Rt=∑_k=0 ^{∞} γ^k r_{t+k}
로 계산하는 것이다. 여기서 γ는 1보다 조금 작은 값(예:0.99)을 사용해 '망각'을 모델링 한다. 
실제로 구현하는 경우에 또 하나 고려할 내용은 각 보상을 표준화(standardise)하는것이다. (역자 주: 이 내용은 생략합니다.)

정책 그라디언트 유도하기

(역자 주: 수식을 쓰기가 어렵기도하고 이 내용은 기본적인 소개보다 살짝 더 나간 부분이라 생략합니다.)

학습

이제 정책망에 대해 이해했으니 실제로 구현을 해보자. 퐁 게임을 130줄짜리 파이썬 코드로 짰다. 이 코드는 OpenAI Gym을 사용했다. 200개의 은닉 노드(hidden node)를 갖는 정책망을 짰고 RMSProp으로 학습을 시켰다. 내 구형 맥북으로 3일동안 학습을 시킨 결과 아타리에 내장된 인공지능보다 퐁을 더 잘 플레이하게 시작했다. 학습기간동안 대략 20만판의 퐁을 플레이했고 최종적으로 800번정도 파라미터를 업데이트했다. 전체 네트워크 구성을 더 정밀하게 짜고, GPU를 써서 더 오래 학습을 시킨다면 이것보다 좋은 결과를 볼 수 있을 것이다. 여기에서는 너무 열심히 최적화를 하진 않았다. 


학습된 결과

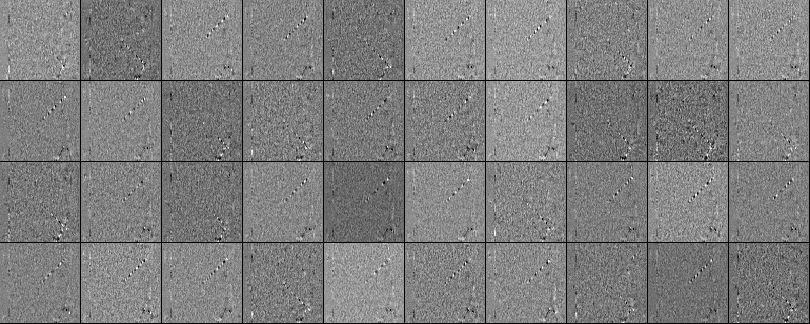
아래 그림은 학습이 끝난 가중치를 시각화한것이다. 위에서 이야기했듯이 (현재 프레임 - 과거 프레임)을 입력으로 사용했다. 아래 그림은 200개 뉴런중 40개를 골랐다. 하얀 픽셀이 양수, 검은 픽셀이 음수다. 이를 보면 몇몇 뉴런은 공의 궤적에 반응하도록 학습이 된것을 알 수 있다. 실제 게임에서 공은 딱 한군데에만 있을 수 있지만 뉴런 하나는 다양한 공의 위치에 반응할 수 있도록 (multi-task) 학습이 되었다. 데이터에 노이즈가 좀 있는데, L2 정규화를 했다면 아마 줄어들었을 것 같다. 


학습 과정에서 일어나지 '않는' 것

지금까지, 픽셀 데이터를 보고 퐁 게임을 하는 정책망을 봤고 실제로 잘 작동한다. 이 방식은 guess-and-check, 즉 판단을 우선 내려보고 그 판단이 잘했는지/못했는지를 확인하는 과정의 반복이다. 세부적인 내용엔 차이가 있지만 이 방식이 현재 가장 잘 작동하는 방식이다. 한편으로 신기하기도 하지만 내막을 알고보면 다소 실망스럽기도 하다. 

사람이 퐁 게임을 학습하는 과정을 생각해보자. 이 게임을 보여주고 게임 방식에 대해 이렇게 설명할 것이다. "너가 저 막대기를 올리거나 내릴 수 있고, 저 공을 쳐내서 상대방이 못받게 하면 너가 이기는거야." 그리고 게임을 시작할 것이다. 이 과정과 강화 학습엔 몇가지 차이가 있다.
  • 우리는 언어를 통해 게임의 룰에 대해 알게되지만 강화학습은 그저 보상 함수가 정해져있고 이를 통해 스스로 게임을 파악해야한다. 만일 아무런 설명도 듣지 못하고 게임을 하게 된다면 강화학습과 같을수도 있다. 어쩌면 그런 상황이라면 강화학습이 사람보다 나을 수도 있다. 또, 만일 화면의 픽셀을 뒤죽박죽으로 섞어 놓아서 뭐가 뭔지 알 수 없게 해놓는다면 사람은 전혀 게임을 이해할 수 없겠지만 정책망 입장에선 데이터일뿐이므로 아무런 차이가 없다.
  • 사람은 공이 튀기는 방식과 같은 물리적인 지식이나, 상대 인공지능도 이기려고 플레이 한다는 등의 사전 지식을 가지고 있다. 또 막대기를 조종하는 것도 쉽게 이해한다. 하지만 알고리즘은 전혀 그런 지식 없이 그냥 작동한다. 한편으로 생각하면 대단하기도 하고, 다르게 생각하면 그 과정을 정확히 이해할 수 없어서 답답하기도 하다.
  • 정책망은 Brute force 방식이다. 즉, 올바른 판단이 무엇인지 모든 경우의수를 다 조사해보고 결과적으로 답을 알게된다. 하지만 사람은 모든 경우를 보지 않아도 추상화 과정을 통해 게임의 작동 방식을 이해한다. 예를 들어 사람은, 퐁 게임에서 인공지능의 움직임이 그렇게 빠르지 않으므로 공을 빠른 속도로 - 즉 직선 코스로 - 보내는 것이 승리하는 방법이라는걸 이해할 수 있다. 하지만 사람도 어떤 경우엔 이런 생각의 과정 없이 무의식적으로 일을 하기도 한다. 예를 들어 수동 기어 차량을 운전하는 법을 배운다면, 처음엔 기어 변속 과정을 머리로 생각하면서 실행하지만 어느 순간이 되면 거의 자동적으로, 무의식적으로 기어 변속을 한다.
  • 정책망은 많은 보상을 받으면서 조금씩 학습하지만 사람은 훨씬 적은 데이터를 가지고도 어떻게 해야 많은 보상을 받는지 이해한다. 예를 들어 차를 운전하는 경우 꼭 벽에 차를 박아보지 않아도 그러면 안된다는걸 알고있다.


하지만 반대의 경우도 굉장히 많다. 즉, 정책망을 사용한 방법이 사람을 쉽게 이기는 경우도 많이 있다. 특히 반응 속도가 굉장히 빨라야 한다거나 아주 까다로운 행동을 취해야 하는 경우에 정책망은 사람보다 훨씬 잘 할 수 있다.

이제 원리를 이해했으니 정책망을 이용한 강화학습의 장단점을 알 수 있다. 아직 인공지능은 사람처럼 복잡하고 추상적인 개념까지 이해하면서 작업을 수행하지는 않는다. 하지만 언젠가는 그런날이 올 것이다.

미분 불가능한 연산을 포함한 인공 신경망

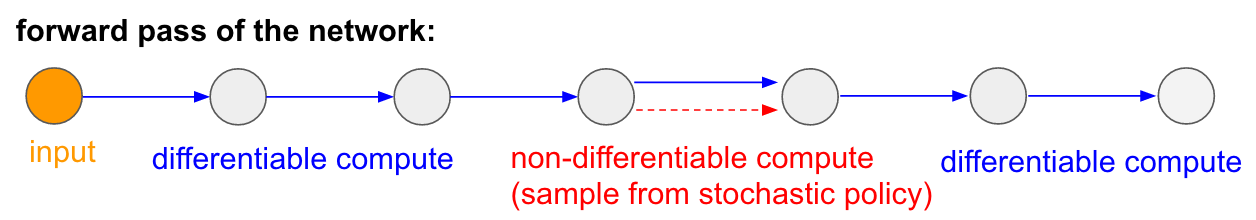
이제 마지막으로 한가지만 더 짚고 넘어가자. 이번에 다룰 이야기는 게임과 무관한 정책망 이야기다. 정책망을 이용하면 미분 불가능한 연산을 포함한 인공 신경망을 사용할 수 있다. 이 방법은 Recurrent Models of Visual Attention 논문에서 처음으로 소개됐다. 이 논문은 RNN으로 이미지에서 어디를 '보아야'(visual attention) 할 것인지를 결정한다. 문제는, 인공 신경망으로 어디를 볼지를 결정하는 과정이 미분 불가능한 연산이라는 점이다. 아래 그림을 보자.


신경망에서 입력이 들어와서 어디를 볼지를 결정하는 과정을 간략히 나타낸 그림이다. 여기에서 대부분의 과정은 미분이 가능하지만 빨간색 화살표로 나타낸, 어디를 볼지를 '확률 분포에 의해 샘플링하는 과정'은 미분이 불가능하다. 따라서 backpropagation을 할 수가 없다.

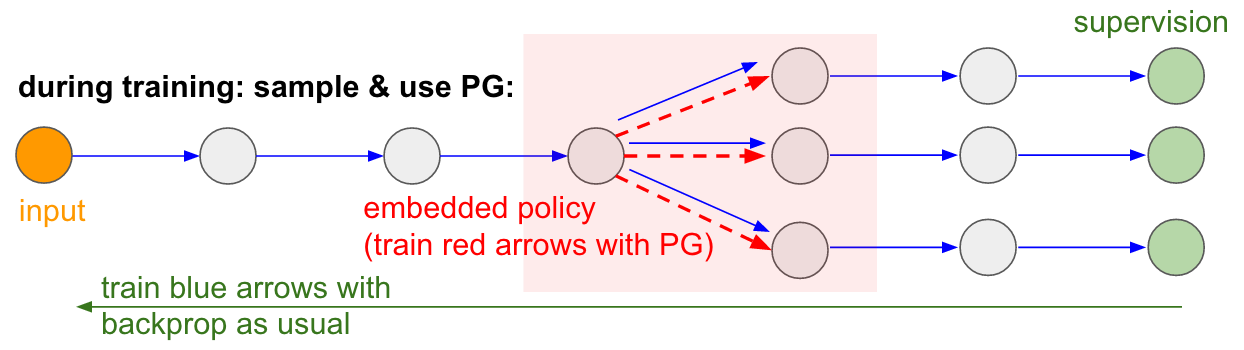
정책망을 이용하면 이 문제를 해결할 수 있다. 위의 그림에서 샘플링하는 경우의 수를 3가지로 보고 나타내면 아래 그림처럼 된다. 학습 과정에서, 여러번의 샘플링이 일어나게 되고 실제로 샘플링의 결과를 따라서 backpropagation을 하면 된다. 이 과정은 Gradient Estimation Using Stochastic Computation Graphs에 잘 나와있다.


학습 가능한 메모리 입/출력

위의 아이디어는 다른 연구에서도 볼 수 있다. 예를 들어 Neural Turing Machine은 '메모리 테입'이라 불리는 요소가 있고 여기에 데이터를 저장하고 불러온다. 뭔가를 저장하려면 m[i]=x 같은 연산을 수행해야하는데, 여기에서 i와 x는 RNN으로 구현된 컨트롤러 신경망이 결정한다. 이 경우도 샘플링이랑 비슷한데, 예를 들어 i가 아닌 위치를 사용할 경우에 발생하는 loss를 알려줄 방법이 마땅치 않다. 따라서 모든 메모리 셀 - 즉 모든 i - 에 대해 어떤 값을 할당할지를 전부 구해주고, i의 확률 분포를 전부 구해야 하는데 이렇게 하면 하나의 쓰기 연산을 위해 메모리 테입의 모든 위치 (모든 i)를 확인해야 한다. 따라서 연산이 엄청나게 비효율적이다.

정책망을 쓰면 이를 효율적으로 해결할 수 있다 (RL-NTM 참조). 위의 여러 과정에서 샘플링을 했던 것 처럼, 메모리의 어디에 쓰기 연산을 수행할지 - 즉 변수 i - 를 샘플링하고 그 결과를 지켜보는 것이다. 실제로는, 수많은 메모리 위치 중에서 정확한 위치 i를 샘플링할 확률이 매우 낮기 때문에 이 방식은 경우의 수가 많은 상황에서는 적합하지 않다.

하지만 언젠가 아주 많은 연산과 데이터가 가능해지면 정책망을 통해 이 문제를 해결하게 될 수도 있다. 그리고 이 모든것이 더욱 더 발전하면 TCP/IP이나 컴파일러 등 복잡한 상황을 인공 신경망을 통해 해결하게 될 수도 있을 것이다.

결론


지금까지 정책망을 이용해 게임을 학습하는 방법을 알아봤다. 몇 가지 내용을 덧붙이겠다.

인공 지능의 발전에 대해

여기서는 모든 경우의 수를 다 탐색하는 (brute-force) 방법으로 알고리즘이 작동하는 것을 보았다. 또 사람은 이 경우에 인공지능과 전혀 다르게 접근한다는 사실도 언급했다. 이 과정에서 라벨을 명시하기에 매우 어려운, 따라서 지도 학습을 통해 풀기 어려운 내용이 많이 있기 때문에 비지도학습에 기반한 생성 모델(unsupervised generative model)이 많은 주목을 받고 있다.

복잡한 로보틱스 문제

이 알고리즘은 정말 많은 판단을 내려야 하는 복잡한 상황에 적용되기엔 연산량이 너무 많다. 예를 들어 자동으로 여러가지를 학습하는 로봇의 경우에 샘플링 기반의 학습은 적합하지가 않으므로 나온 방법이 deterministic policy gradients다. 그 외에도 구글의 로봇 팔이나 테슬라의 자동 운전 등의 다른 접근이 있다.

그 외에도 경우의 수를 탐색하는 과정을 최적화 하는 다양한 시도가 있다. 예를 들어 알파고는 무작위 판단이 아니라 사람이 선택한 경우의 수를 기반으로 학습의 효율을 높였다. (역자 주: 이 문단 뒤쪽은 생략합니다)

현실에서 정책망을 사용하는 방법

마지막으로, 내 RNN 포스팅과 비슷하게 마무리를 짓고싶었다. 아무래도 내 RNN 포스팅을 읽은 사람들이 RNN을 이용하면 이 세상의 모든 sequence 데이터와 관련된 문제를 해결할 수 있다고 생각하는 것 같다. 하지만 실제로는 여러가지 까다로운 문제를 해결해야 RNN을 잘 활용할 수 있고, 굳이 RNN을 사용하지 않아도 될 수도 있다.

정책망도 마찬가지다. 이 모든 과정은 완전 자동이 아니고, 데이터가 아주 많이 필요하고, 학습 과정이 엄청나게 오래 걸리고, 잘 작동하지 않는 경우엔 디버깅을 하기가 매우 까다롭다. 정책망을 적용하기 전에 먼저 Cross-entropy method를 베이스라인으로 구현해봐야한다. 그리고 나서도 정책망을 사용하려고 한다면 각종 책과 논문에 나온 나온 팁을 아주 자세히 보고, 아주 간단한 구성부터 시작을 해야한다. 그리고 일반적인 정책망보다는 약간 변형된 방법인 TRPO를 시도해보도록 해라. 대부분의 경우에 더 잘 작동한다고 알려져있다. TRPO의 핵심은 ...(역자 주: 제가 정확히 몰라서 이부분 생략합니다).

자, 이제 포스팅을 마친다. 이 포스팅으로 강화 학습에 대해 잘 이해했길 바란다. 강화 학습 연구에 더 본격적으로 참여하고 싶다면 OpenAI Gym을 활용하길 바란다.